
刚接触深度学习时,最容易被模型名字带跑偏:CNN、LSTM、Transformer,好像每一种都要重新学一套东西。其实它们的训练过程非常相似。数据变成张量,模型给出预测,损失函数衡量偏差,反向传播计算梯度,优化器再更新参数。循环往复,仅此而已。
这篇先不追求高准确率。目标是搭出一份足够小、能读懂、以后还能继续改的 PyTorch 训练骨架。
学完要能回答什么
- 一个 batch 从
DataLoader出来后经历了什么; - 为什么训练阶段需要
model.train(),验证阶段需要model.eval(); zero_grad()、backward()和step()为什么缺一不可;- loss 下降不等于模型一定可用,验证集又在检查什么;
- 如何让同一份代码自动选择 CUDA 或 CPU。
如果你对数组形状还不熟,可以先看站内的 NumPy 基础文章。深度学习里大量错误,本质上仍然是形状没对上。
1. 先把训练过程说成人话
假设我们要根据两个输入特征判断样本属于 0 类还是 1 类。模型一开始的参数是随机的,预测自然也不靠谱。每轮训练做五件事:
- 取一批样本;
- 用当前参数算出预测;
- 比较预测和真实标签,得到损失;
- 从损失倒推每个参数应该往哪边改;
- 按学习率移动一点点。
这里的“一点点”很重要。学习率过大,参数会跨过合适位置来回震荡;过小,训练又像挪椅子,每次只挪一毫米。
图解:训练阶段根据 loss 更新参数;验证阶段使用 eval 与禁用梯度,两者职责不同。流程为概念图,不是实验结果。
沿图检查一次 batch:先断言输入是浮点数、标签是 long,再核对输出第一维仍为 B。loss.backward() 只计算并累积梯度,真正改变权重的是 optimizer.step()。在下一次反向传播前清零梯度;若有意做梯度累积,则明确累积步数和 loss 的缩放。验证时记录整个集合的加权损失,不能把大小不同的 batch 均值直接平均。
动手核对: 只取 16 个样本,检查模型能否把训练误差压低;再打乱这些样本的标签比较记忆能力。这个检查用于定位训练链路问题,不能证明泛化。保存 seed、样本索引和每轮 loss。
实测补充:一次能独立复跑的训练
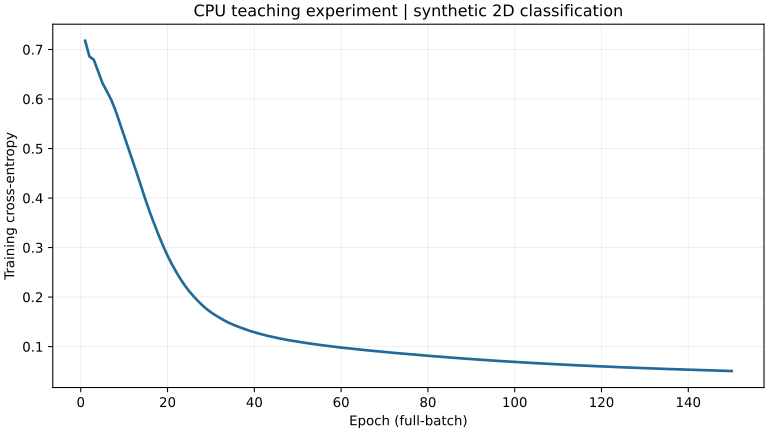
图:CPU 实测训练交叉熵,不是验证曲线,也不是业务数据基准。原始数据可下载:每轮 loss CSV、环境与结果 JSON。
这份附加实验使用另一条非线性规则 x1 * x2 > 0,与下文用于讲解的线性标签规则不同。固定 seed=42,1,500 个训练样本、500 个留出测试样本,2→32→2 的 Tanh 网络,Adam 学习率 0.03,全批量训练 150 轮。本次训练损失从 0.717663 降到 0.050663,最后一次测试准确率为 0.980。没有搜索超参数,也没有用测试结果选择轮次。
复跑入口是仓库的 examples/blog/run-examples.py。在仓库根目录执行 python examples/blog/run-examples.py,依赖和验证范围见同目录 README。图中的下降只能说明此合成任务的优化有效;换成有噪声、不平衡或分布变化的数据时,必须重新设置验证协议。
2. 一份最小但完整的数据集
为了看清流程,先用可控的合成数据。下面的标签规则很简单:x1 + x2 > 0 记作 1,否则记作 0。
import random
import numpy as np
import torch
from torch.utils.data import DataLoader, TensorDataset, random_split

SEED = 42
random.seed(SEED)
np.random.seed(SEED)
torch.manual_seed(SEED)

x = torch.randn(2000, 2)
y = (x[:, 0] + x[:, 1] > 0).long()

dataset = TensorDataset(x, y)
train_size = int(len(dataset) * 0.8)
val_size = len(dataset) - train_size
train_set, val_set = random_split(
    dataset,
    [train_size, val_size],
    generator=torch.Generator().manual_seed(SEED),
)

train_loader = DataLoader(train_set, batch_size=64, shuffle=True)
val_loader = DataLoader(val_set, batch_size=128, shuffle=False)
训练集使用 shuffle=True,避免模型每轮都按相同顺序看数据。验证集不更新参数,通常无需打乱。random_split 也传入固定随机种子,这样重启 Notebook 后,训练集与验证集不会悄悄换一批样本。
在 Windows 的 Notebook 中,先把 num_workers 保持为 0。多进程加载确实可能更快,但也是初学阶段最常见的卡死来源之一。数据规模变大后再调。
3. 模型、损失函数与优化器
两层全连接网络已经够用了:
from torch import nn

class TinyClassifier(nn.Module):
    def __init__(self) -> None:
        super().__init__()
        self.net = nn.Sequential(
            nn.Linear(2, 16),
            nn.ReLU(),
            nn.Linear(16, 2),
        )

    def forward(self, inputs: torch.Tensor) -> torch.Tensor:
        return self.net(inputs)

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
model = TinyClassifier().to(device)
criterion = nn.CrossEntropyLoss()
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
最后一层输出两个数字,叫作 logits。它们不是概率,不需要手动做 Softmax。CrossEntropyLoss 会完成适合分类任务的数值稳定计算,标签则应是 torch.long 类型的类别编号。
一个很典型的错误是:模型最后已经加了 Softmax,随后又把结果交给 CrossEntropyLoss。这样相当于重复处理,梯度可能变得难学。训练时直接输出 logits;只有展示预测概率时才调用 softmax。
4. 训练一个 epoch
def train_one_epoch(
    model: nn.Module,
    loader: DataLoader,
    optimizer: torch.optim.Optimizer,
    criterion: nn.Module,
    device: torch.device,
) -> tuple[float, float]:
    model.train()
    loss_sum = 0.0
    correct = 0
    sample_count = 0

    for features, labels in loader:
        features = features.to(device)
        labels = labels.to(device)

        optimizer.zero_grad(set_to_none=True)
        logits = model(features)
        loss = criterion(logits, labels)
        loss.backward()
        optimizer.step()

        batch_size = labels.size(0)
        loss_sum += loss.item() * batch_size
        correct += (logits.argmax(dim=1) == labels).sum().item()
        sample_count += batch_size

    return loss_sum / sample_count, correct / sample_count
四行核心代码值得背下来,但更值得理解:
optimizer.zero_grad(set_to_none=True)
logits = model(features)
loss = criterion(logits, labels)
loss.backward()
optimizer.step()
PyTorch 默认会累加梯度,所以每个 batch 开始前要清掉旧梯度。backward() 只负责计算并写入梯度,真正修改参数的是 optimizer.step()。如果漏掉最后一步,loss 会原地踏步;如果漏掉第一步,多个 batch 的梯度会叠在一起,训练行为就变了。
损失统计乘以 batch_size,是为了正确处理最后一个不足整批的 batch。直接平均每个 batch 的 loss,在各批大小不同时会产生轻微偏差。
5. 验证阶段为什么不一样
验证有两个独立开关:eval() 改变 Dropout、BatchNorm 等层的行为,关闭梯度记录则避免建立不需要的计算图。二者不是替代关系。验证结束后再次训练,也要恢复训练模式;否则程序可以继续运行,但训练行为已悄悄改变。
@torch.inference_mode()
def evaluate(
    model: nn.Module,
    loader: DataLoader,
    criterion: nn.Module,
    device: torch.device,
) -> tuple[float, float]:
    model.eval()
    loss_sum = 0.0
    correct = 0
    sample_count = 0

    for features, labels in loader:
        features = features.to(device)
        labels = labels.to(device)
        logits = model(features)
        loss = criterion(logits, labels)

        batch_size = labels.size(0)
        loss_sum += loss.item() * batch_size
        correct += (logits.argmax(dim=1) == labels).sum().item()
        sample_count += batch_size

    return loss_sum / sample_count, correct / sample_count
model.eval() 会切换 Dropout 和 BatchNorm 等层的行为;torch.inference_mode() 告诉框架不用构建反向传播所需的信息,节省内存和计算。两者用途不同,不能互相替代。
把训练与验证串起来:
for epoch in range(1, 21):
    train_loss, train_acc = train_one_epoch(
        model, train_loader, optimizer, criterion, device
    )
    val_loss, val_acc = evaluate(model, val_loader, criterion, device)

    print(
        f"epoch={epoch:02d} "
        f"train_loss={train_loss:.4f} train_acc={train_acc:.3f} "
        f"val_loss={val_loss:.4f} val_acc={val_acc:.3f}"
    )
预期现象是训练损失逐渐下降,训练与验证准确率一起上升,随后趋于稳定。这里不规定某个精确数字,因为初始化、依赖版本和硬件都可能带来差异。更重要的是趋势:训练集越来越好,而验证集长期不改善,通常意味着过拟合或数据分布有问题。
6. 保存的应该是“最好的一次”
best_val_loss = float("inf")

for epoch in range(1, 21):
    train_loss, train_acc = train_one_epoch(
        model, train_loader, optimizer, criterion, device
    )
    val_loss, val_acc = evaluate(model, val_loader, criterion, device)

    if val_loss < best_val_loss:
        best_val_loss = val_loss
        torch.save(
            {
                "model_state": model.state_dict(),
                "optimizer_state": optimizer.state_dict(),
                "epoch": epoch,
                "val_loss": val_loss,
            },
            "best-tiny-classifier.pt",
        )
只保存最后一次并不稳妥。模型可能在第 12 轮验证最好,第 20 轮已经过拟合。保存参数字典比直接序列化整个模型对象更容易迁移,也更不依赖原始类的导入路径。
7. 常见故障先查什么
| 现象 | 第一检查点 | 常见原因 |
|---|---|---|
| loss 完全不变 | 参数是否真的更新 | 漏了 step()、参数被冻结 |
loss 变成 nan | 输入和学习率 | 数据含无穷值、学习率过大 |
| CUDA 报设备不一致 | 模型与张量所在设备 | 只移动了模型,忘了移动标签 |
| 分类损失报类型错误 | 标签 dtype | 标签应为 long 类别编号 |
| 训练很好,验证很差 | 数据划分与过拟合 | 数据泄漏、分布偏移、模型太复杂 |
| 验证结果每次飘 | 模式和随机性 | 漏了 eval()、随机种子不完整 |
调试时不要同时改五个地方。先取一个 batch,打印 shape、dtype、数值范围和设备,再尝试过拟合几十条样本。连很小的数据都学不会时,问题通常在代码或标签,而不是模型不够大。
8. 练习
- 把隐藏层从 16 改成 4、32、128,观察参数量与训练趋势。
- 故意删掉
zero_grad(),记录 loss 有什么变化,并解释梯度累加。 - 把二分类规则改成圆形边界:
x1² + x2² > 1,看看没有隐藏层的线性模型会怎样。 - 为训练循环加入简单的早停:验证损失连续若干轮不改善就退出。
9. 面试时怎么讲
问:训练集、验证集和测试集分别做什么?
训练集更新参数;验证集选择模型和超参数;测试集只在最终方案确定后评估泛化能力。反复根据测试集调参,会让测试集也参与决策,最后的分数就不再可信。
问:为什么验证时还要调用 model.eval()?
它会让 Dropout 停止随机丢弃,并让 BatchNorm 使用已积累的统计量。只关闭梯度并不会自动改变这些层。
问:一个标准训练 step 的顺序?
清梯度、前向计算、计算损失、反向传播、参数更新。混合精度或梯度累加会增加步骤,但基本职责不变。
下一篇
这篇把训练循环跑通了,但 loss.backward() 仍像一个黑盒。下一篇会拆开计算图、链式法则和反向传播:神经网络为什么能学习。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。