
RNN 把历史压进隐藏状态,并按顺序读取 token。这个过程自然表达顺序,却限制了并行,也让远距离关系必须经过很多时间步。注意力机制换了一个问题:处理当前位置时,序列中哪些位置最值得参考?
Transformer 不等于“更大的 RNN”。它用注意力直接连接不同位置,再通过位置编码补回顺序信息。本篇以编码器分类任务为主,先看清 Q、K、V,再实现一个带掩码的 PyTorch 模型。
1. 从检索理解 Q、K、V
可以把注意力想成一次可学习检索:
- Query:当前位置正在寻找什么;
- Key:每个位置可以用什么特征被匹配;
- Value:匹配后真正取回的信息。
Q、K、V 都由输入经过不同线性变换得到。Query 和 Key 的相似度决定权重,再对 Value 加权求和。它们并不是三份不同原文,而是三种任务角色。
输入 X
 ├─ Wq → Q
 ├─ Wk → K
 └─ Wv → V

Q 与 K 计算匹配分数 → softmax → 对 V 加权求和
2. 缩放点积注意力
核心公式是:
QK^T 生成位置两两之间的分数矩阵。若序列长度为 L,它的最后两维通常是 L×L。这解释了标准自注意力在长序列上的显存压力。
除以 是为了避免维度增大后点积绝对值过大,导致 softmax 过早饱和。饱和时大部分权重接近 0,梯度会变得尖锐而不稳定。
import math
import torch

def scaled_dot_product_attention(q, k, v, mask=None):
    scores = q @ k.transpose(-2, -1) / math.sqrt(q.size(-1))
    if mask is not None:
        scores = scores.masked_fill(mask, float("-inf"))
    weights = torch.softmax(scores, dim=-1)
    return weights @ v, weights
掩码中的 True 表示不可关注位置。实际项目要确认具体 API 的布尔语义,不能凭经验把 0 和 1 互换。
图解:每个 query 对 key 位置分配权重,再对 value 求加权和。padding mask 与因果 mask 约束不同的位置。
注意力矩阵的一行对应一个 query。softmax 应沿 key 维计算,否则就不是“这个 query 从哪些位置读取信息”。若一整行 key 全被屏蔽,需要显式处理空上下文,避免产生无效数值。可视化时同时标注 token,颜色深浅才有解释对象;注意力权重也不能直接当作完整的因果解释。
动手核对: 构造 3 个 token 的 Q、K、V,手算第一行分数并核对权重和为 1。加入因果 mask 后,验证第一个 token 不读取后两个位置。
实测图:逐行检查因果掩码
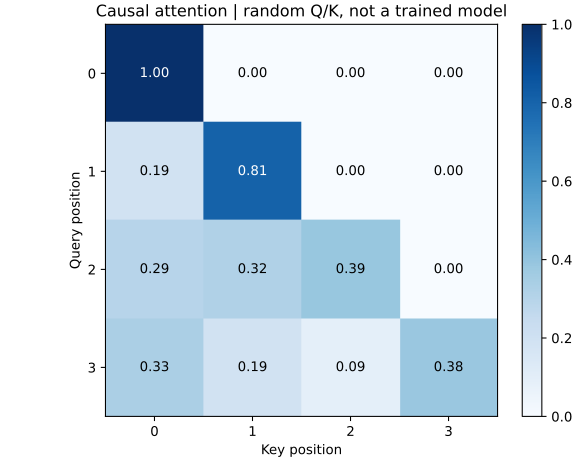
图:固定随机种子的单头教学实验,4 个 token、d_k=3。横轴是被查询位置,纵轴是发起查询位置。它不是训练后模型的解释图。
第一行只能关注自己,因此权重为 [1,0,0,0]。第二行可访问前两个位置;未来位置在 softmax 前设为负无穷,归一化后为零。每一行的权重和都应接近 1。仓库的 attention_check()同时断言这两个条件,数值矩阵与图使用同一次计算结果。
注意:下文讨论的是整句分类编码器,它通常允许双向注意力;这里的因果图用于理解自回归约束,不能不加区分地套进分类模型。若一整行都被屏蔽,普通 softmax 可能产生 NaN,因此真实实现还应处理空序列和全 PAD 输入。
3. 多头注意力为什么不是简单重复
单头只有一组投影。多头注意力把表示分到多个子空间,让不同头可以关注不同关系,例如邻近搭配、指代或句法边界。各头输出拼接后再做一次线性变换。
from torch import nn

mha = nn.MultiheadAttention(
    embed_dim=256,
    num_heads=8,
    dropout=0.1,
    batch_first=True,
)

x = torch.randn(16, 50, 256)
padding_mask = torch.zeros(16, 50, dtype=torch.bool)
output, weights = mha(
    x,
    x,
    x,
    key_padding_mask=padding_mask,
)
embed_dim 必须能被 num_heads 整除。头数更多不等于效果必然更好,因为每个头分到的维度也会变小。
4. 没有循环后,顺序从哪里来
自注意力本身对位置置换不敏感。若交换输入 token,同时交换对应行,计算关系不会自动知道谁在前谁在后。因此需要把位置信息加入 token 表示。
经典正弦位置编码使用不同频率:
class SinusoidalPositionEncoding(nn.Module):
    def __init__(self, d_model: int, max_length: int = 2048) -> None:
        super().__init__()
        positions = torch.arange(max_length).unsqueeze(1)
        scales = torch.exp(
            torch.arange(0, d_model, 2) * (-math.log(10000.0) / d_model)
        )
        pe = torch.zeros(max_length, d_model)
        pe[:, 0::2] = torch.sin(positions * scales)
        pe[:, 1::2] = torch.cos(positions * scales)
        self.register_buffer("pe", pe.unsqueeze(0), persistent=False)

    def forward(self, x):
        return x + self.pe[:, : x.size(1)]
位置编码也可以学习。选择哪种形式取决于长度外推、模型结构和训练规模,本篇先用固定编码减少额外变量。
5. 编码器层的四个关键部件
一个常见 Transformer 编码器层包含:
- 多头自注意力;
- 残差连接;
- 层归一化;
- 逐位置前馈网络。
前馈网络对每个位置独立使用同一组参数,通常先扩大维度、激活,再投回模型维度。注意力负责位置间交换信息,前馈网络负责变换每个位置的表示。
norm_first=True 表示先归一化再进入子层,常被称为 Pre-Norm。它与 Post-Norm 的训练性质不同,但不应脱离深度和已有配方孤立比较。
6. PyTorch 编码器分类模型
下面模型使用 padding_idx=0,在编码器后做带 mask 的平均池化。它不依赖特殊的 [CLS] token,因此更容易替换自己的词表。
class TransformerClassifier(nn.Module):
    def __init__(self, vocab_size: int, num_classes: int) -> None:
        super().__init__()
        d_model = 256
        self.embedding = nn.Embedding(vocab_size, d_model, padding_idx=0)
        self.position = SinusoidalPositionEncoding(d_model)
        layer = nn.TransformerEncoderLayer(
            d_model=d_model,
            nhead=8,
            dim_feedforward=768,
            dropout=0.1,
            activation="gelu",
            batch_first=True,
            norm_first=True,
        )
        self.encoder = nn.TransformerEncoder(layer, num_layers=4)
        self.head = nn.Sequential(
            nn.LayerNorm(d_model),
            nn.Dropout(0.2),
            nn.Linear(d_model, num_classes),
        )

    def forward(self, token_ids):
        padding_mask = token_ids.eq(0)
        x = self.embedding(token_ids) * math.sqrt(self.embedding.embedding_dim)
        x = self.position(x)
        x = self.encoder(x, src_key_padding_mask=padding_mask)

        valid = (~padding_mask).unsqueeze(-1)
        pooled = (x * valid).sum(dim=1) / valid.sum(dim=1).clamp_min(1)
        return self.head(pooled)
这里有两处容易漏掉:位置编码应和模型处于同一设备;池化分母必须按有效 token 数计算。register_buffer 会让位置编码随模型迁移设备,又不会被优化器更新。
7. 三种掩码不要混淆
Padding mask
屏蔽补齐位置,避免真实 token 读取 PAD。形状通常按批次和序列长度组织。
Causal mask
屏蔽未来位置,用于自回归生成。分类编码器通常可以看完整句子,不需要因果掩码。
Loss mask
当每个位置都要计算损失时,用它忽略 PAD 或无标签位置。它作用在损失层,不等同于注意力掩码。
一个常见错误是只在 loss 里忽略 PAD,却允许注意力反复读取 PAD;另一个错误是在分类任务误加 causal mask,让双向上下文退化成单向。
8. 训练成本和长度选择
标准注意力要构造位置两两关系,长度翻倍时,注意力矩阵元素数量约变为四倍。最大长度不能只按“越长越完整”决定,应先统计分布:
- 大多数样本覆盖到哪里;
- 被截断部分是否包含关键信息;
- 长文本能否按段落或窗口处理;
- 显存和响应时间预算是多少。
对文本分类,合理截断、分块汇总或层次模型往往比盲目扩大上下文更可靠。
9. 优化与稳定性
Transformer 常对学习率更敏感。先保持变量少:固定优化器和调度策略,只调整一个因素,并记录验证损失与梯度情况。
optimizer = torch.optim.AdamW(
    model.parameters(),
    lr=3e-4,
    weight_decay=1e-2,
)

optimizer.zero_grad(set_to_none=True)
logits = model(token_ids)
loss = nn.functional.cross_entropy(logits, labels)
loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), 1.0)
optimizer.step()
若损失不下降,先验证一个小批次能否过拟合,再检查标签、mask、学习率和输出维度。直接增加层数通常只会让问题更难定位。
10. 注意力权重能否解释模型
注意力权重能展示某一层某一头的分配,但不能自动等同于因果解释。多层传播、残差和前馈网络都会改变最终预测。可视化适合发现异常,例如模型大量关注 PAD 或固定标点;若要解释决策,还应结合遮挡、梯度归因和错误样本分析。
11. 数学补充:矩阵形状
调试这一步时,我建议先把矩阵的行和列写清楚。省略批次维,令输入 : 是序列长度, 是每个 token 的表示维度。下面先看一个注意力头。
投影矩阵分别为 和 。三次矩阵乘法使用同一个输入,但学习不同的映射:
因此 ,而 。转置后的 是 ,内侧维度相同,乘积保留外侧两个维度:
这里的第 个元素表示位置 的 Query 与位置 的 Key 的匹配分数,还不是概率。完整的缩放点积注意力是:
是掩码:允许访问的位置加 0,需要屏蔽的位置加负无穷。softmax 沿最后一维进行,所以每一行表示一个 Query 对所有 Key 的权重分配;在至少有一个有效 Key、且尚未做 attention dropout 时,行和为 1。如果一整行都被屏蔽,计算可能产生 NaN,需要在数据或 mask 构造阶段避免。
最后的乘法为 ,输出 的形状是 。例如 、,分数矩阵是 ,每个位置最终得到一个 8 维向量。序列长度没有改变,改变的是每个位置的信息来源。
回到多头实现时,加上批次维和头数: 常写成 ,分数是 。代码里的 transpose(-2, -1) 只交换最后两个维度,不交换批次或头数。先核对这些形状,再查 mask 的广播范围,就能把大多数维度错误定位到具体一步。
12. 练习与面试表达
- 打印每层输入输出形状,确认序列维没有和批次维交换。
- 分别移除位置编码和 padding mask,观察训练行为应如何变化。
- 将带 mask 平均池化替换为可学习
[CLS]表示。 - 估算长度从 256 增加到 512 时注意力矩阵元素数变化。
面试表达可围绕约束展开:任务是整句分类,因此采用双向编码器而非因果 mask;数据长度分布决定截断上限;PAD 同时在注意力和池化阶段屏蔽;先用小模型验证管线,再讨论预训练模型或更长上下文。
下一篇
理解模型结构后,还需要把训练、保存、恢复和推理组织成稳定流程。下一篇切换到工程视角:TensorFlow/Keras 训练与部署工作流。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。