
新模型的点击率略有提升,能不能上线?单看差值还不够:需要知道样本量、实验持续时间、分流方式,以及两组用户是否可比。下面按一次实验评审的顺序,把这些问题拆开。读完之后,目标是能解释一个结论有多可靠,而不只是会算 p 值。
这篇把 A/B 测试拆成工程流水线:实验设计 → 样本量预估 → 运行与监控 → 统计推断 → 决策与复盘,每一步给 Python 代码和真实坑点。
前置阅读:建议先读 Pandas 数据分析与可视化、机器学习数学基础(概率与分布部分)。
假设检验:一个反直觉的框架
A/B 测试的统计内核是假设检验,它的逻辑是反着的:先假设「没效果」(原假设 H₀),再看数据有多不可能。
- H₀(原假设):新策略没有效果,观察到的差异只是随机波动。
- H₁(备择假设):新策略真有效。
- p 值:在 H₀ 和检验模型成立时,获得当前或更极端检验统计量的概率。p=0.03 不是“差异由运气造成的概率为 3%”。是否拒绝 H₀ 要依据预设的显著性水平和停止规则,不能看到数据后再改方向。
最常见的误读必须钉死:p = 0.03 不是「新策略有效的概率是 97%」,也不是「效应有 3% 概率是巧合」这种贝叶斯解读。频率学派的 p 值只陈述「在 H₀ 下数据的极端程度」。这个误读在业务方那里极其普遍,解释清楚是数据科学家的日常。
两类错误是对称的风险:
| H₀ 真(没效果) | H₀ 假(真有效) | |
|---|---|---|
| 拒绝 H₀ | 一类错误,概率由检验程序控制 | 检出效应 |
| 不拒绝 H₀ | 未误拒 | 二类错误,概率依赖具体效应与样本量 |
α 是指定程序在 H₀ 下的长期误拒概率;功效 1−β 需要指定非零效应、样本量和变异程度。低功效不等于实验没有信息,但不显著时不能据此证明无效。是否上线还要考虑业务价值和护栏风险。
样本量:实验前必须算,不是跑完再说
「跑多少样本够」取决于四个量:基线转化率、最小可检测效应(MDE)、α、power。二分类指标(点击率/转化率)的公式:
下面使用 statsmodels 的 Cohen’s h 正态功效近似,它与上面的未变换比例近似不是同一个数值公式;记录采用的方法,不把两者当作逐位相同的实现:
import math
from statsmodels.stats.power import NormalIndPower
from statsmodels.stats.proportion import proportion_effectsize

# 基线转化率 5%,想检测 +0.5pp(相对提升 10%)的变化
effect = abs(proportion_effectsize(0.05, 0.055))
n = NormalIndPower().solve_power(
    effect_size=effect, alpha=0.05, power=0.8, ratio=1, alternative="two-sided")
print(f"每组需要 {math.ceil(n):,} 样本")   # 本次环境:每组 31,218,总量 62,436
几个违反直觉但重要的直觉:
- MDE 越小通常需要更多样本;讨论基线高低时还要区分绝对与相对 MDE。上面的正态近似未包含聚类、流失或多重检验调整,不能直接作为所有产品的流量预算。
- 样本量必须在实验前算好,然后跑满再分析。「边跑边看,显著了就停」是最经典的作弊(见下文多重比较)。
实战:完整分析一次实验数据
使用教学计数:对照组 52,000 用户、2,600 人转化,实验组 51,800 用户、2,720 人转化。假设每名用户只有一次转化/未转化观测,两组独立;不能把重复访问当成独立用户扩大样本量:
import numpy as np
from statsmodels.stats.proportion import proportions_ztest, confint_proportions_2indep

n_a, c_a = 52000, 2600   # 对照组
n_b, c_b = 51800, 2720   # 实验组

# 双侧方向在观察数据之前确定
z, p = proportions_ztest([c_b, c_a], [n_b, n_a], alternative='two-sided')

# 效应量与置信区间
diff = c_b / n_b - c_a / n_a
ci_low, ci_high = confint_proportions_2indep(
    c_b, n_b, c_a, n_a, compare='diff', method='newcomb')

print(f"转化率: A={c_a/n_a:.4%}  B={c_b/n_b:.4%}")
print(f"绝对提升: {diff:+.4%}  95%CI [{ci_low:+.4%}, {ci_high:+.4%}]")
print(f"z={z:.2f}, p={p:.4f}")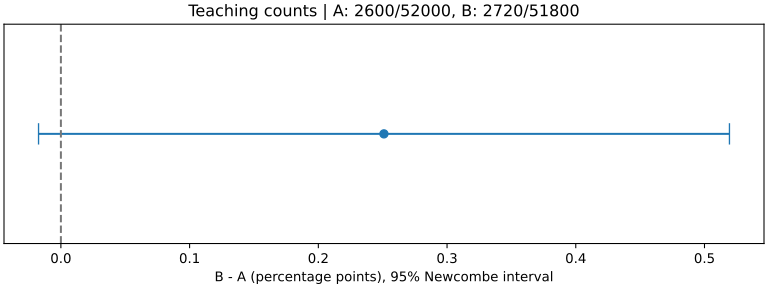
本次运行:差值 +0.2510 个百分点,95% Newcombe 区间约为 [−0.0174,+0.5194] 个百分点,双侧 p≈0.066748。按预设双侧 5% 检验,不能拒绝 H₀,也不能宣称确定提升。
该区间接口只返回两个端点,差值自行计算。Statsmodels 接口定义。检验与同一种方法反演得到的区间有对应关系;本例 pooled z 检验和 Newcombe 区间不是同一种反演方法,边界附近不保证逐点等价。频率学派 95% 区间描述程序的长期覆盖性质,不是给本次固定参数赋 95% 概率。
连续指标(人均时长、客单价)用 t 检验或非参数检验:
from scipy import stats

# 方差齐性未知,用 Welch's t(别默认 equal_var=True)
t, p = stats.ttest_ind(durations_b, durations_a, equal_var=False)

# 若研究问题是秩/分布关系,可考虑 Mann-Whitney U;它不是均值检验的通用替代
u, p_mw = stats.mannwhitneyu(durations_b, durations_a, alternative='greater')
六大翻车现场:实验设计的坑
下面是需要排查的设计风险,不是本次已经发生的线上事故:
1. 边跑边看(peeking problem)。用固定样本检验的阈值反复做效果决策,会改变整体误拒概率。持续监控故障和数据质量没有问题;效果决策需要预设固定终点,或使用有效的序贯方法。
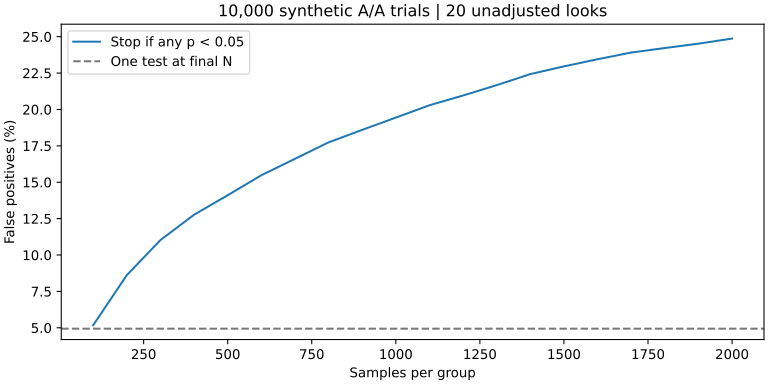
本次 seed=42 的 10,000 次合成 A/A 模拟,两组均为标准正态、已知方差为 1,每组每次增加 100 个样本,共看 20 次。终点只检验一次的误拒比例为 4.94%;任一次 p<0.05 就停止的比例为 24.87%。这个数依赖查看次数和设计,不能当作所有实验的固定膨胀率。原始曲线 CSV
2. 多重比较。若 20 个检验相互独立、H₀ 都成立、每个 α=0.05,则至少一次误拒概率为 1−0.95²⁰≈64.15%;相关指标不能直接套这个精确数值。预先声明主指标与成功标准,区分家族错误率和 FDR 控制。共同主指标不必只有一个,但必须设计多重检验策略。
3. 辛普森悖论。聚合与分组结论可能因权重变化而相反。先区分预先确定的协变量分层与受实验处理影响的实验后分层;后者可能引入选择偏差,不能见到反转就只相信子组结论。
4. 分流不均(SRM)。比较观测人数与设计比例。显著偏离是调查信号,不自动证明某一种 bug;要追踪分流、曝光、过滤和日志丢失。解释清楚之前暂停因果结论。下面默认设计为 50/50,其他比例必须显式传 f_exp:
from scipy.stats import chisquare
stat, p_srm = chisquare([n_a, n_b])  # 阈值应预先定义;显著时调查原因
5. 新奇效应与周周期。覆盖完整业务周期有助于估计长期平均效果,但周中开始、下一周同一天结束也能覆盖完整一周。同时随机化的两组共享日历窗口,非整数周不会自动使两组星期结构不同。需另外评估新奇效应、节假日和人群变化。
6. 网络效应与干扰。用户互相影响时(社交、拼车、市场类),随机分流到个人会破坏独立性——对照组的行为被实验组「污染」。对策:按社群/城市/时间片分流(cluster randomization、switchback),这是因果推断的前沿,至少要知道它的存在。
实验平台的最小功能清单
自己搭或评估公司内部平台时,按这个清单核对:
- 分流:同一实验期间同一用户稳定分组,实验标识参与哈希;支持分层互斥实验层
- SRM 自动检查,异常自动熔断
- 指标守护:主指标 + 护栏指标(收入、崩溃率、延迟),护栏恶化自动降级
- 样本量计算器内置,实验前强制预估
- 方差缩减:CUPED 使用不受实验处理影响的前置协变量;收益通过数据验证,不预先承诺固定比例。
CUPED 的常见线性形式为 Y_adj = Y − θ(X − E[X]),其中 θ = Cov(X,Y)/Var(X),不是一般意义上的相关系数。最优线性调整的理论方差比为 1−ρ²,实际收益受估计误差与适用假设影响。本次用独立合成数据估计并应用 θ,设定相关系数 0.6,得到 θ≈0.5981、方差比≈0.6512;这不是业务数据收益。
上线决策框架
数据都显著了,上还是不上?我的决策矩阵:
| 情形 | 决策 |
|---|---|
| 主指标满足预设成功标准,护栏通过 | 结合风险分阶段放量并继续监控 |
| 主指标正向但 CI 下界 < 业务最小价值 | 看工程成本,低成本上,高成本弃 |
| 主指标不显著且区间很宽 | 记录信息不足;按预设调整规则或新实验设计继续,不能随意追加直到显著 |
| 主指标显著负向 | 回滚,复盘假设 |
| 主指标不动、护栏恶化 | 回滚 |
放量后仍需监控长期效应。可考虑保留长期 holdout 组,但比例要根据功效、风险和业务成本决定,5% 不是通用标准;长期流失与组间污染也需要检查。
踩坑排查
| 现象 | 原因 | 解法 |
|---|---|---|
| p 值天天波动,忽显著忽不显著 | 边跑边看 | 定死样本量,跑满再分析 |
| 实验组对照组量级对不上 | 分流 bug / 上报丢失 | SRM 卡方检查,查分流日志 |
| 指标显著但全量后没效果 | 新奇效应 / 实验期太短 | 跑整数周,看老用户子群,长期 holdout |
| 小效应怎么测都不显著 | 样本量不够(功效不足) | 事先算 n,或加大 MDE 预期 / CUPED 降方差 |
| 同一实验不同人算出不同结论 | 口径不一致(去重逻辑、时间窗) | 指标定义文档化,分析代码版本化 |
| 转化率类指标波动巨大 | 样本里混了机器人/异常流量 | 先做反作弊过滤再进分析 |
练习
- 两组都用 8% 转化率模拟,估计 H₀ 下的一类错误率;再把 B 改为 8.8%,估计该效应下的功效。二者回答不同问题。
- 写 peeking 模拟:实验期间每天算一次 p 值,只要某天 <0.05 就停。重复 1000 次,看假阳性率膨胀到多少。
- 用 statsmodels 算样本量:基线 3%,MDE 相对提升 5%/10%/20%,画出「MDE-所需样本量」曲线。
- 实现 CUPED:造一份「实验前活跃度 X 与实验期时长 Y 相关 ρ=0.6」的模拟数据,对比校正前后置信区间宽度。
面试常问
Q:p 值的准确定义?常见误读? 在 H₀ 为真的前提下,观察到当前或更极端结果的概率。三大误读:① p = H₀ 为真的概率(错,频率学派不给假设赋概率);② 1−p = 结论可复现的概率(错);③ p > 0.05 证明没效应(错,可能是功效不足)。
Q:一类错误和二类错误的关系? 此消彼长:α 定得更严(0.05→0.01),假阳性降但假阴性升(功效降)。固定 α 下提升功效的三条路:增大样本、增大真实效应(做更大的改动)、降低方差(CUPED/分层)。样本量计算本质就是在这四个量之间解方程。
Q:为什么要跑满整数周? 完整业务周期有助于代表目标使用场景,不保证消除新奇效应或分布变化。两组若同时随机分流,本来就共享相同日历窗口;停止日期、最短周期与样本量都应在实验前约定。
Q:什么时候用 t 检验、z 检验、卡方、非参数? 比例类二项指标(转化/点击)大样本 → 两比例 z 检验;连续均值 → Welch’s t 检验;分类分布差异 → 卡方检验;偏态/小样本/秩相关 → Mann-Whitney U 等非参数。默认记住 Welch 不用 Student(不等方差假设更安全)。
Q:如何提高实验灵敏度(同样流量测更小的效应)? 可比较协变量调整、分层设计和更高质量的指标;触发分析要排除处理后选择偏差。聚类随机化能缓解某些干扰,但组内相关通常降低有效样本量,不是免费提高灵敏度。不能脱离数据承诺 MDE 缩小比例。
Q:AA 测试是什么,为什么做? 两组都上相同版本,运行完整流程。单次 A/A 仍可能正常误拒;应通过重复试验及不确定性判断误拒频率、SRM 和数据链路,而不是要求每次都不显著。
相关阅读
本文可复跑入口:examples/blog/review-examples.py。环境与实测结果 JSON保存样本量、双侧 p 值、区间和模拟配置。无网络请求,全部为教学输入。
- Pandas 数据分析与可视化实战——实验数据加工的主场
- 机器学习数学基础——概率分布与统计量的地基
- 时间序列分析实战——全量后长期效应监控的工具
- 研究方法:AI 论文与实验设计——从工业实验到学术实验的思维
- 数据可视化与叙事——把实验结论讲给决策者的艺术
A/B 测试教会我的最重要一课:数据不会自己说话,统计框架是防止我们自欺欺人的纪律。下次看到「提升了 0.3%」,你的第一反应应该是三句话:样本量多少?置信区间多宽?实验设计干净吗?

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。