
时间序列是有顺序的数据:股价、流量、销量、服务器监控。它和普通回归的本质区别在顺序不能打乱——今天的数据和昨天相关,随机切分训练/测试集就是作弊(时间泄漏,机器学习基础讲过这个坑)。这篇从经典统计方法讲到深度学习路线。
前置阅读:Pandas 数据分析(时间索引操作)、线性回归(回归评估语言)。
先分解:趋势、季节、残差
拿到序列的第一件事是分解——把时间序列拆成三个可解释的成分:
from statsmodels.tsa.seasonal import seasonal_decompose
import pandas as pd

ts = pd.read_csv("sales.csv", parse_dates=["date"], index_col="date")["y"]
ts = ts.sort_index()
if ts.index.has_duplicates:
    raise ValueError('重复日期需要先按业务口径聚合')
ts = ts.asfreq('D')
if ts.isna().any() or len(ts) < 44:
    raise ValueError('示例需要连续日数据,且保留30天测试后训练段至少有两个周周期')
result = seasonal_decompose(ts.iloc[:-30], model="additive", period=7)

result.plot()   # 趋势(长期方向)+ 季节(周期波动)+ 残差(剩下的噪声)
period=7 表示七个观测点,只有连续日频才对应一周。这里仅分解训练段;默认双侧滤波会使用某个时点之后的值,适合离线描述,不能直接作为实时预测特征。缺测日不能默认填成零,是否补零、插值或保留缺失要先看数据含义。
平稳性与 ARIMA:统计派的基本功
AR(自回归)用过去 p 个值预测当前;MA(移动平均)用过去 q 个预测误差;I 是差分(d 阶,把不平稳变平稳)。ARIMA(p,d,q) 三参数的逻辑:
- d:结合趋势设定、单位根检验和残差诊断选择,避免机械差分。确定性趋势、结构突变和随机趋势不是同一种问题。
- p/q:纯 AR/MA 的截尾特征可作线索;混合 ARMA 的 ACF/PACF 不一定清楚截尾。信息准则筛候选后,仍需按真实预测步长回测。
from statsmodels.tsa.arima.model import ARIMA

# 时间序列切分:按时间先后切,绝不随机打乱
train, test = ts.iloc[:-30], ts.iloc[-30:]

model = ARIMA(train, order=(2, 1, 2)).fit()
forecast = model.forecast(steps=30)

from sklearn.metrics import mean_absolute_error
print(f"MAE: {mean_absolute_error(test, forecast):.2f}")
ADF 的原假设是存在单位根。p>0.05 只是不拒绝单位根原假设,不能据此证明非平稳,更不能自动决定差分;检验结果依赖滞后项、趋势项和样本量。ADF 官方定义
上面的 ARIMA 是示例阶数,不是已选出的最优模型。季节性可考虑 SARIMA,外生变量可考虑带 exog 的模型;外生变量在预测时是否已知同样需要审查。
Prophet:业务预测的速食面
Prophet 将趋势、季节项和节假日效应组合成可解释的模型。下面只演示接口,是否优于季节朴素基线必须回测,不能因代码短就认为无需调参:
from prophet import Prophet

df = pd.DataFrame({"ds": ts.index, "y": ts.values})   # Prophet 固定列名
m = Prophet(yearly_seasonality='auto', weekly_seasonality=True)
m.add_country_holidays(country_name="CN")              # 节假日效应
m.fit(df.iloc[:-30])

future = m.make_future_dataframe(periods=30)
pred = m.predict(future)
m.plot(pred)   # 预测值与区间
m.plot_components(pred)   # 趋势、季节和节假日成分
年周期需要足够历史支持;短序列不应强行拟合。Prophet 支持自定义季节项和额外回归变量,但未来回归变量也要可获得。区间覆盖率需要回测,不等于真实未来必然落在图中的带状区域。本轮未安装或执行 Prophet。
预测图与成分图的调用可查 Prophet 官方快速入门。
机器学习与深度学习路线
构造滚动均值、标准化和缺失填补时,也要遵守预测时点。即使最终按时间切分,若特征提前用到了未来窗口,仍然存在泄漏。评估应模拟当时能拿到的信息,而不是事后整理完整的表格。
把时序转成监督学习(滑窗构造特征:滞后值、滚动统计、时间特征),然后 LightGBM 直接上——实践中这是打榜和业务的常见强者,能随便加外部特征(天气、促销标记)。
深度路线(LSTM/Transformer)在多序列联合建模(几千个商品一起学)时有优势,单序列场景常常打不过 LightGBM——别为了用深度学习而用。构造时序特征的示例:
def make_features(ts, lags=(1, 2, 3, 7, 14)):
    if not isinstance(ts.index, pd.DatetimeIndex) or not ts.index.is_monotonic_increasing or ts.index.has_duplicates:
        raise ValueError('需要升序且无重复的时间索引')
    if any(not isinstance(lag, int) or lag < 1 for lag in lags):
        raise ValueError('lag 必须为正整数')
    df = pd.DataFrame({"y": ts})
    for l in lags:
        df[f"lag_{l}"] = ts.shift(l)
    df["roll_mean_7"] = ts.shift(1).rolling(7).mean()  # shift(1) 防泄漏!
    df["dow"] = ts.index.dayofweek
    return df.dropna()
注意 shift(1):滚动统计只能用 t-1 及之前的数据,直接用当天值就是泄漏——时序特征的泄漏比任何其他任务都容易犯。
这个函数针对每天拿到昨日真实值后预测今天的一步协议。若在月初一次预测未来 30 天,不能提前用测试月真实值生成其余 29 天的 lag;需递归使用预测值、直接多步模型,或分别建立各 horizon 的特征。测试日期之前不等于预测时点之前。
实跑:同一截止日,两种预测协议
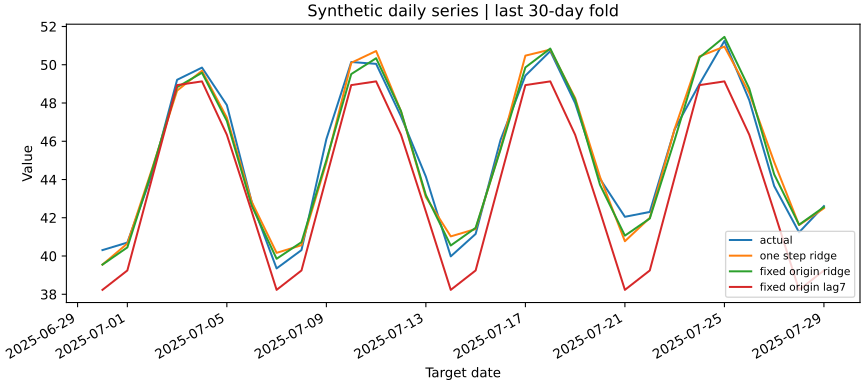
配图来自固定种子的合成趋势、周周期和噪声,不是真实销量。脚本在相同三折时间窗口比较 lag-7 基线与标准化 Ridge:训练与标准化都只拟合各折过去数据,一步协议逐日接收真实观测,多步协议递归回填预测。逐日期结果、折边界和 MAE 写入 CSV 与 JSON。不根据最终测试成绩再调参数。
另一个回归断言会把未来一段值加上大扰动,确认较早时点的特征完全不变。它能抓到 center=True、负向 shift 等实现错误,但不能自动证明外部特征没有延迟发布或事后修订。
复跑入口为 review-model-validation.py。最后一折中 Ridge 的一步 MAE≈0.517、固定起点 MAE≈0.489;多步误差不必在每个样本、每一折都更大,协议应由使用场景决定,而不是挑分数好看的那个。
踩坑排查
| 症状 | 原因 | 处理 |
|---|---|---|
| 测试集分数高得反常 | 随机切分导致时间泄漏 | 按时间切分,滚动验证 |
| 特征里有当天信息 | 滚动统计没 shift | shift(1) 再 rolling |
| ARIMA 远期趋向常数或直线 | 可能是模型正常的长期行为,也可能设定不合适 | 与季节基线、残差和预测协议一起检查,不单凭曲线形状判错 |
| 节假日附近全预测错 | 模型不知道节假日 | Prophet 加假日 / 加假日特征 |
| 长 horizon 预测发散 | 递归预测误差累积 | 直接多步模型或接受短 horizon |
| 深度学习打不过基线 | 单序列数据量不足 | 换 LightGBM/Prophet |
练习
- 对一份销量序列做分解,判断周期成分并说明建模启示。
- 用 ADF 检验判断平稳性,实现 ARIMA 并用滚动验证评估。
- 用 Prophet 预测并解读它的趋势/周期分解图。
- 构造滑窗特征训练 LightGBM,与 ARIMA/Prophet 在同一切分下对比。
面试常问
Q:时序任务为什么不能随机切分数据?
对“用过去预测未来”的任务,随机切分通常不匹配部署条件。优先按时间切分并做滚动起点验证;同一对象的重叠标签窗口还要考虑隔离间隙。TimeSeriesSplit 的 gap 是样本数,不会自动识别业务标签跨度;要比较相同时间长度的折还需要等间隔观测。官方说明
Q:ARIMA 的 p、d、q 怎么定? ADF、ACF/PACF 与 AIC/BIC 提供候选线索,不直接给出唯一正确阶数。要检查趋势设定、过度差分和残差,并用与部署相同的 horizon 比较候选。
Q:Prophet 和 ARIMA 怎么选? 单变量、强统计规律、需要区间理论严谨——ARIMA;业务序列、多周期、有节假日效应、要快——Prophet;要加大量外部特征、多序列——机器学习路线。
Q:递归多步预测的误差累积怎么缓解? 递归(用预测值当输入继续预测)会让误差滚雪球。方案:直接训练每个 horizon 的模型、Seq2Seq 多步输出、或限制预测步长。评估时按 horizon 分层报告误差。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。