
手动试几个参数之后,常见的困惑是:下一组该改什么,前面的结果还值不值得参考?Optuna 可以管理试验、选择参数和提前停止表现不佳的运行,但它不能替你定义可靠的验证集。这里先确定评估规则,再比较网格搜索、随机搜索和自适应搜索,最后把流程写成代码。
前置阅读:建议先读 机器学习基础与 Scikit-learn、模型评估与类别不平衡。
调参为什么是个真问题
模型的超参数通常不由这次常规拟合直接求出,可以靠搜索、经验或专门的优化方法选择。实际困难在于:
- 搜索空间组合爆炸:6 个参数各取 5 个候选值就是 15625 种组合。
- 评估昂贵:每组参数要完整训练一次,深度学习里一次就是几小时。
- 参数间有交互:learning_rate 和 n_estimators 互相耦合,不能独立调。
候选很少时,枚举仍是可解释的基线;维度和单次成本增大后,再考虑随机或自适应策略。
基线方法:网格与随机
网格搜索(Grid Search):遍历笛卡尔积。每个参数各取 5 个值时,3 个参数是 125 次、6 个是 15625 次;不能脱离取值数量估算预算,也不能预先断言某个学习率在所有任务中无效。
随机搜索(Random Search):在空间中随机采样 N 个点。Bergstra & Bengio 的经典结论是:当只有少数参数真正重要时,随机搜索比网格高效得多——网格在不重要的参数上浪费了大量试验,随机的每个点都在探索新的重要参数组合。
两者共同的缺陷:完全不看历史结果。第 100 次试验和第 1 次一样盲目,前面 99 次失败的经验全被浪费了。
贝叶斯优化:让历史指导下一步
贝叶斯优化的核心思想:把「超参数 → 验证分数」看成一个未知的黑盒函数,用已有试验结果拟合一个代理模型(surrogate),再用它预测「哪里最可能出好成绩」,优先去那里试。
每轮迭代做两件事:
- 用已有 (参数, 分数) 更新采样策略,本文显式指定 TPE,避免依赖任务类型或版本的默认设置。
- 用采集函数(EI:期望改进)平衡「利用」(在已知好区域附近挖潜)和「探索」(去不确定的新区域碰运气),选出下一组参数。
直觉类比:老手调参就是这么干的——「上次 lr=0.01 比 0.1 好,那往 0.005 附近再试试,同时 max_depth 还没怎么探索过,也带上一组」。贝叶斯优化是把老手的直觉数学化了。
Optuna 实战
Optuna 的 API 设计是我见过最干净的,核心就三个概念:objective(目标函数)、trial(一次试验)、study(一场研究):
import optuna
from xgboost import XGBClassifier
from sklearn.model_selection import StratifiedKFold, cross_val_score

# 假设 X_train/y_train 是已隔离最终测试集后的开发数据,且标签为二分类。
# 同一用户多行或时间序列不能直接使用此随机分层折法。
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)

def objective(trial):
    params = {
        "max_depth": trial.suggest_int("max_depth", 3, 10),
        "learning_rate": trial.suggest_float("learning_rate", 1e-3, 0.3, log=True),
        "n_estimators": trial.suggest_int("n_estimators", 100, 1000),
        "min_child_weight": trial.suggest_int("min_child_weight", 1, 10),
        "subsample": trial.suggest_float("subsample", 0.5, 1.0),
        "colsample_bytree": trial.suggest_float("colsample_bytree", 0.5, 1.0),
        "reg_lambda": trial.suggest_float("reg_lambda", 1e-3, 10.0, log=True),
    }
    model = XGBClassifier(**params, eval_metric="logloss", n_jobs=1, random_state=42)
    score = cross_val_score(model, X_train, y_train, cv=cv, scoring="roc_auc", error_score="raise").mean()
    return score

study = optuna.create_study(
    direction="maximize",
    sampler=optuna.samplers.TPESampler(seed=42),
)
study.optimize(objective, n_trials=100, n_jobs=1)

print(study.best_params, study.best_value)
两个细节决定成败:
搜索空间设计:log=True 让相同比例区间获得相同采样权重,适合正数、跨数量级的候选;它不证明某次绝对变化对分数影响更大。边界须符合参数定义,例如 subsample 不能用默认值的 10 倍;还要记录边界是否在看过验证结果后修改。
剪枝不是配置一个 pruner 就自动发生。 上面的 cross_val_score 一次返回最终均值,没有 trial.report / trial.should_prune,所以不声称它中途剪枝。真正需要剪枝时,在训练循环中上报可比较进度的验证指标,并显式抛出 TrialPruned。MedianPruner 比较当前 trial 到目前的最佳中间值与此前完成 trial 在相同步的中位数,还受启动、预热与最小样本条件约束。官方说明
# 结构示意:必须放在 objective(trial) 内,并提供真实训练/验证实现
# study 需显式配置 pruner=optuna.pruners.MedianPruner(n_warmup_steps=5)
for epoch in range(epochs):
    val_score = train_one_epoch(...)
    trial.report(val_score, epoch)
    if trial.should_prune():
        raise optuna.TrialPruned()
对照实验:先把预算和证据说清楚
旧版的“微调从 3 天缩到 1.5 天”与下列 AUC 排名没有对应数据、trial 日志或设备记录,不能继续当作实测。原表还混合“固定两小时”和“两周业余时间”,预算不可比。下面改为验收模板:
| 策略 | 必须记录 | 当前证据 |
|---|---|---|
| 网格搜索 | 完整候选、CV 折、每候选分数 | 新增小型合成实验 |
| 随机搜索 | 分布、种子、候选数、相同 CV 折 | 新增小型合成实验 |
| TPE + 剪枝 | 完成/剪枝/失败 trial、报告步、累计资源 | 未运行,不填成绩 |
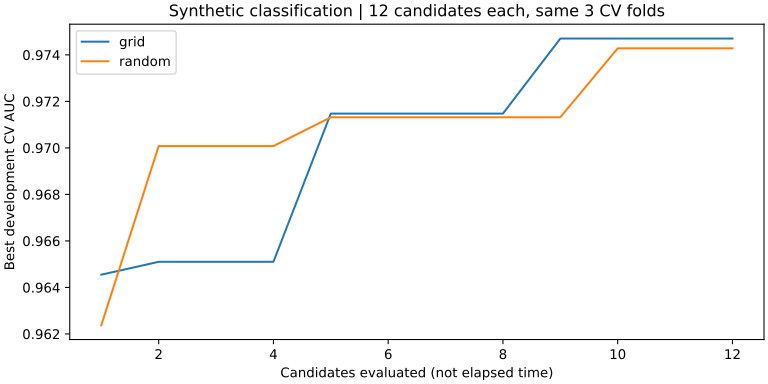
新图比较固定种子下各 12 个候选、相同三折 CV 的随机森林搜索。数据在搜索前分出最终测试集;按开发集 CV 选择策略和参数,最终只评估胜出模型一次。曲线来自真实执行,但候选数相同不等于耗时相同,单种子也不能证明某种搜索普遍更好。候选记录 CSV · 结果 JSON
本机没有 Optuna,本轮没有安装它或运行上述 XGBoost/剪枝示例;不能把 sklearn 实验标成 TPE 实测。要补齐比较,需在独立环境固定 Optuna 版本、同一数据切分、墙钟/资源预算并重复多个种子。
复跑入口为 review-model-validation.py。本次开发集 CV 最佳 AUC 为网格 0.974702、随机 0.974281;据此选择网格候选,最终测试 AUC 为 0.976177。这个差距很小,不构成方法优越性的统计证据。
AutoML:再往上抽象一层
AutoML 可以进一步管理预处理、模型与集成,但仍需要你定义标签、数据可用时点、验证切分和资源约束。可把 AutoML 作为候选基线,不承诺“十分钟胜过人工一周”;未超过某条基线也不能单独证明数据是唯一瓶颈。
踩坑与排查
| 症状 | 可能原因 | 排查方法 |
|---|---|---|
| 搜出的参数在测试集翻车 | 过拟合验证集 | 用嵌套 CV 或独立 holdout;搜索轮数别超预算 |
| 搜索结果和默认值差不多 | 搜索空间设错 | 检查 log 尺度;先单参数敏感性分析再定范围 |
| 每次搜索结果不同 | 随机性未固定/目标函数有噪声 | 固定 seed;CV 折数加大;多次取均值 |
| 剪枝把好试验误杀 | 学习曲线前期噪声大 | 加大 n_warmup_steps;换 PatientPruner |
| 搜索不收敛,分数乱跳 | 目标函数本身不稳定 | 先解决训练稳定性,再谈调参 |
| 100 次试验没超过基线 | 参数不在关键路径上 | 回去改特征/数据,超参不是瓶颈 |
动手练习
- 用 Optuna 调一个随机森林(至少 4 个超参数),和 GridSearchCV 对比相同时间预算下的最佳分数。
- 给 objective 加
trial.report+ 剪枝,统计剪枝节省了百分之多少的计算。 - 用
optuna.visualization.plot_param_importances分析哪个超参数最重要,解释为什么。
面试常问
Q:贝叶斯优化和随机搜索的本质区别? 随机搜索每次采样与历史无关;贝叶斯优化用历史结果建代理模型,预测最有希望的区域优先采样,是「有记忆的搜索」。在评估昂贵(每组参数训练很久)、搜索空间有限轮次时,贝叶斯优化收敛到好解所需的试验次数显著更少;评估便宜时两者差距不大,随机搜索反而并行友好。
Q:TPE 和高斯过程(GP)贝叶斯优化的区别? GP 直接建模目标函数 p(y|x),在连续低维空间表现好,但 O(n³) 复杂度和对类别/条件参数支持差;TPE 反过来建模 p(x|y好) 和 p(x|y差) 两个密度,用比值引导采样,天然支持树状条件搜索空间(比如「用 Adam 才有 beta1」),试验数多时也更快。Optuna 默认 TPE 就是因为它更适合真实 ML 搜索空间。
Q:调参会过拟合验证集吗?怎么防? 会。CV 也用于选择候选,不能自动消除选择偏差。独立测试集只在冻结方案后使用;需要评估搜索流程本身时使用嵌套 CV。提前约定预算、指标和候选范围,记录试过的所有方案,不给出无法操作的“有效假设数”通用上限。
调参的终极目标不是找到「最优参数」,而是建立一个可复现、有预算、不骗人的搜索流程。工具只是这个流程的加速器。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。