
这是”机器学习基础”小系列的第一篇。这个系列共四篇:本篇搭框架,后面三篇分别吃透三个最经典的算法——线性回归、决策树、K-Means 聚类。
看懂模型公式后,拿到一份表格仍可能不知道从哪开始:先填缺失值,还是先切分?训练分数很好,为什么不能直接交付?这篇用一个小分类任务把这些步骤接起来。代码不复杂,重点是弄清每一步能看哪些数据,以及最终分数究竟回答了什么问题。
前置阅读:Pandas 数据分析与可视化。特征工程的输入输出都是 DataFrame。
机器学习到底在干什么
一句话:从数据里学出一个函数 f,让 f(特征) ≈ 标签,并且这个函数在没见过的新数据上也要准。
按”标签长什么样”分三大类:
| 任务类型 | 标签 | 例子 | 典型算法 |
|---|---|---|---|
| 回归 | 连续数值 | 预测房价、预测引用数 | 线性回归、随机森林 |
| 分类 | 离散类别 | 垃圾邮件识别、论文领域分类 | 逻辑回归、决策树、SVM |
| 聚类 | 没有标签 | 用户分群、文档分组 | K-Means、DBSCAN |
前两类叫监督学习(有老师教),聚类是无监督学习(自己找结构)。本篇用一个分类任务串流程,后三篇各覆盖一类算法。
完整流程:六步走
先用鸢尾花数据集演示独立样本分类。换成用户行为、时间序列或同一患者的多条记录时,切分方式也要跟着改,不能原样照搬随机划分:
# example: iris-setup
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report, confusion_matrix

# 1. 拿数据
X, y = load_iris(return_X_y=True)

# 2. 切分:训练集学知识,测试集当"高考",训练过程绝不许碰
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 3-4. 特征处理 + 训练,用 Pipeline 捆在一起
pipe = Pipeline([
    ("scaler", StandardScaler()),       # 标准化:减均值除标准差
    ("model", LogisticRegression(max_iter=200)),
])
pipe.fit(X_train, y_train)

# 5-6. 先不看测试分数、不保存初始模型;完成下文搜索后统一评估与保存。
这段代码里最重要的设计是 Pipeline。它把标准化和模型捆成整体,fit 时标准化器只在传入的训练数据上学习均值方差,predict 时复用参数。它能防住这条链路的预处理泄漏,但不能自动发现未来字段、重复用户或错误切分。
数据泄漏:机器学习的第一大隐形杀手
看这段错误示范:
# ❌ 错误:先标准化全量数据,再切分
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)     # 全量数据(含测试集)参与了统计
bad_train, bad_test, bad_y_train, bad_y_test = train_test_split(X_scaled, y)
问题在于标准化用了全部 150 条数据的均值和方差,测试集参与了预处理参数的估计。这里泄漏的不是标签,而是测试数据的分布信息。它未必让这一次分数明显升高,但评估已经偏离了“对未见数据预测”的条件;不能用分数没变来证明流程没有问题。
检查泄漏时,可以沿着数据产生的时间往回查:
- 预处理泄漏:上面这种,统计量在全量数据上算。
- 特征泄漏:使用预测时尚不可得的信息。预测下个月流失时,本月已有的客服工单可以是合法特征;流失确认后补录的注销原因则不能使用。判断依据是可用时间,不是字段名看起来像不像标签。
- 时间泄漏:用未来数据预测过去。做时间序列任务时切分必须按时间切,不能随机打散。
Pipeline + 只在训练集 fit,能系统性地防住第一类;后两类要靠特征审查和正确的切分策略。
评估:别只看准确率
classification_report 按类别列出 precision、recall、f1-score 和 support(该类真实样本数),另列整体 accuracy 与汇总平均。读分数前先确认正类和平均方式:
- 精确率 Precision:预测为正的里面,真对的比例。“宁可漏报不可错报”的场景看它(垃圾邮件)。
- 召回率 Recall:真正的正例里,被抓出来的比例。“宁可错杀不可放过”的场景看它(疾病筛查、故障检测)。
- F1:两者的调和平均,不考虑真负例,也不自动体现业务代价。多分类 macro-F1 给每类相同权重;是否合适仍取决于任务。
- 准确率 Accuracy:整体对的比例。类别均衡时直观,不均衡时是陷阱——99% 负例的数据集,全猜负也有 99% 准确率。
一次划分的结果有运气成分,所以用交叉验证拿更稳的估计:
# example: iris-cv
from sklearn.model_selection import cross_val_score

scores = cross_val_score(pipe, X_train, y_train, cv=5, scoring="f1_macro")
print(f"5 折 F1: {scores.mean():.3f} ± {scores.std():.3f}")
这里仅在训练部分做 5 折交叉验证,保留测试集供方案确定后评估。折间均值用于比较候选方案,标准差提示划分敏感性,不是置信区间,也不能直接预测上线波动。同一用户有多条记录时,应按用户分组切分;有时间先后关系时,应使用时间切分。
特征工程:把输入处理接进模型
前面的 iris 输入全是数值。下面是另一种输入结构的写法:假设表格包含年龄、收入、城市和职业。它只展示混合列预处理,不覆盖前面已经训练的 pipe,也不能直接用于 iris 数组。
# example: mixed-pipeline
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from sklearn.compose import ColumnTransformer
from sklearn.impute import SimpleImputer

# 数值列标准化,类别列独热编码,用 ColumnTransformer 分列处理
preprocess = ColumnTransformer([
    ("num", Pipeline([
        ("fill", SimpleImputer(strategy="median")),
        ("scale", StandardScaler()),
    ]), ["age", "income"]),
    ("cat", Pipeline([
        ("fill", SimpleImputer(strategy="most_frequent")),
        ("encode", OneHotEncoder(handle_unknown="ignore")),
    ]), ["city", "job"]),
])

mixed_pipe = Pipeline([
    ("prep", preprocess),
    ("model", LogisticRegression(max_iter=500)),
])
这里用 np.nan 表示缺失,填充值也只从训练折学习。handle_unknown="ignore" 将某列的未知类别编码为该列对应的一组全零,而不是拒绝输入;这不意味着预测可靠。上线仍要检查未知类别比例、字段类型和整列缺失情况。
距离模型、带正则的线性模型和许多迭代优化器通常受益于标准化。普通最小二乘的预测在可逆列缩放下理论上不变,但数值条件可能改变;树通常无需缩放。稀疏矩阵不能随意减均值,否则可能稠密化并耗尽内存。先检查表示与模型,再选变换。
调参:先网格搜索,别上来就 AutoML
# example: iris-search
from sklearn.model_selection import GridSearchCV

param_grid = {
    "model__C": [0.01, 0.1, 1, 10],          # 正则强度的倒数;越小约束越强
}

search = GridSearchCV(pipe, param_grid, cv=5, scoring="f1_macro", n_jobs=1)
search.fit(X_train, y_train)

print(search.best_params_, search.best_score_)注意参数名的写法:model__C 里的 model 是 Pipeline 里的步骤名,双下线是约定。调参的铁律:搜索过程只用训练集(GridSearchCV 内部会做交叉验证),测试集留到最后摸一次。拿着测试集反复调参,等于把测试集也变成了训练集。
小数据教学示例使用单进程 n_jobs=1,避免进程启动开销及环境差异;并行度应在目标环境单独验证,不能默认占用全部 CPU。
最后才评估与保存
默认 refit=True 已用选中参数重新拟合全部训练数据,现在才执行第五步:
# example: iris-final
final_model = search.best_estimator_
y_pred = final_model.predict(X_test)  # 一次最终预测,多项指标共享结果
print(classification_report(y_test, y_pred, zero_division=0))
print(confusion_matrix(y_test, y_pred))
第六步保存选定模型。这里在临时目录演示自己创建的可信模型往返,目录退出即清理。实际交付还需字段约定、依赖版本、训练数据版本和评估记录。
# example: iris-persistence
import joblib
import numpy as np
from pathlib import Path
from tempfile import TemporaryDirectory

with TemporaryDirectory(prefix="iris-demo-") as directory:
    path = Path(directory) / "iris-pipeline.joblib"
    joblib.dump(final_model, path)
    loaded = joblib.load(path)  # 只加载自己生成且可信的文件
    np.testing.assert_array_equal(loaded.predict(X_train[:5]), final_model.predict(X_train[:5]))
不要加载来路不明的 joblib/pickle 文件:反序列化可能执行任意代码,跨 sklearn 版本加载也不受支持。见 官方持久化说明。
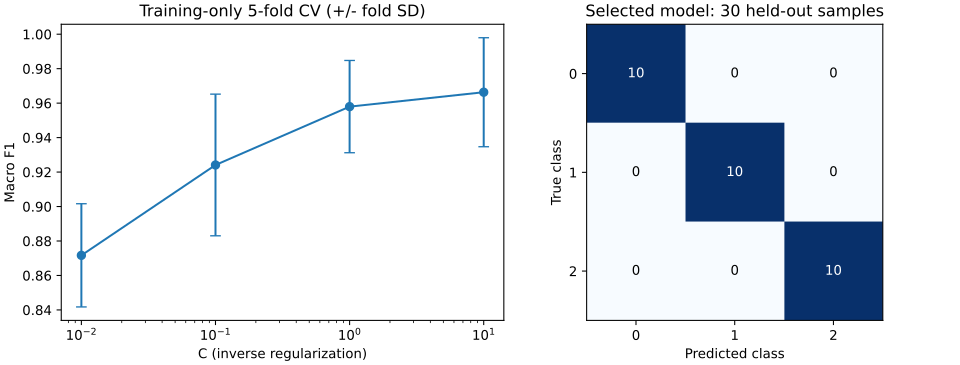
左图每个 C 仅使用 120 个训练样本内部的五折分数,误差线是折间标准差,不是置信区间;右图才使用预留的 30 个测试样本。不能反过来按测试矩阵选 C,小数据集的一次成绩也不代表部署表现。
复跑:python examples/blog/review-ml-foundations.py。脚本提取本文标有 # example: 的代码块依次执行,并检查混合列缺失值、未知类别和持久化往返。结果与环境记录实际版本;未运行真实业务服务。
踩坑排查清单
| 症状 | 原因 | 处理 |
|---|---|---|
| 训练集 99%,测试集 70% | 过拟合 | 加正则、减特征、加数据;用学习曲线确认 |
| 评估分数高得反常(99.9%) | 大概率数据泄漏 | 审查特征是否含”答案近亲”,检查预处理顺序 |
could not convert string to float | 类别列没编码就喂模型 | OneHotEncoder / ColumnTransformer |
ConvergenceWarning | 迭代次数不够或没标准化 | max_iter 调大 + 加 StandardScaler |
| 交叉验证分数方差大 | 数据量少或划分敏感 | 检查分组/分层和样本量;增加数据,勿假定加折数必然降低方差 |
| 新数据预测全是一类 | 训练/线上特征分布不一致 | 对比两边特征分布,检查预处理是否对齐 |
练习
- 对比“先标准化再切分”和“Pipeline 内标准化”的统计量来源。分数即使相同,也要说明哪一步使用了测试信息;不要为了展示泄漏而挑选差异最大的随机种子。
- 换用
load_wine数据集,用 ColumnTransformer 做一次完整建模,并做 5 折交叉验证。 - 给逻辑回归调
C参数([0.001, 0.01, 0.1, 1, 10, 100]),画出验证分数随 C 变化的曲线,找出过拟合和欠拟合区间。 - 构造一个类别 9:1 不均衡的数据集(
make_classification的weights参数),对比准确率和 F1 的差异。
放进贯穿项目:论文分类基线
把 iris 换成论文元数据时,先写清任务:根据提交时已有的标题、摘要等字段预测领域。不要把后续人工审核结果、发表后的引用数混进输入。同一论文的不同版本应放在同一数据分区,避免模型在测试集中再次看到近似副本。
作品集里保留切分清单、完整 Pipeline 和按类别的错误样本。读者应能回答:模型在哪些领域容易混淆?这些错误来自标签重叠、摘要信息不足,还是类别样本太少?比起只展示一个总体准确率,这些内容更能说明你理解了任务。
面试常问
Q:什么是数据泄漏,怎么防? 测试集的信息以任何形式参与了训练过程,都是泄漏。常见形态:预处理统计量在全量数据上算、特征含标签近亲、时间序列随机切分。防法:Pipeline 封装预处理并只在训练集 fit、特征审查、时间任务按时间切分。
Q:为什么交叉验证比单次划分好? 单次划分容易受样本分配影响。K 折交叉验证让每条训练数据轮流参与验证,提供多个划分下的表现,但不能一概称为无偏估计。反复用同一组折选模型也会产生选择偏差,所以仍需保留独立测试集,或采用嵌套交叉验证。
Q:精确率和召回率怎么权衡? 看业务代价:误判为正的代价高(把正常邮件扔进垃圾箱)保精确率;漏掉正例的代价高(漏诊)保召回率。技术上通过调整分类阈值在两者之间移动,用 PR 曲线选工作点。
Q:树模型为什么不需要特征标准化? 按单列阈值分裂的树通常不需要标准化;线性缩放保留排序。但浮点误差、并列候选可能影响实现结果,不能承诺逐位一致;任意非线性单调变换也可能改变相邻训练值之间的新样本路由。距离模型和带正则的线性模型则通常对尺度敏感。
Q:Pipeline 除了防泄漏还有什么用?
把流程变成单一对象,一次 fit/predict 调完全部步骤;GridSearchCV 可以搜索预处理和模型参数。保存完整链路能减少训练与推理处理不一致的风险,但仍需检查输入字段、单位、依赖版本与数据漂移。
流程跑通了,接下来把经典算法一个个吃透。下一篇:线性回归:最朴素的模型,最多的坑。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。