
线性回归容易写出第一版,但要解释系数、检查残差、判断预测是否可信,还需要走几步。下面用同一个问题串起模型假设、参数求解、诊断和正则化。复习时可以先回答:这个线性关系为什么合理,哪些数据现象会让它失效?
前置阅读:机器学习基础与 Scikit-learn(流程框架)。本篇是机器学习小系列第 2 篇。
模型的直觉:找一条”总误差最小”的线
给定特征 ,线性回归假设标签 是特征的线性组合加噪声:
训练的目标:找一组 和 ,让预测值和真实值的平方误差之和最小:
为什么用平方误差而不是绝对值误差?两个原因:平方项处处可导,有解析解(最小二乘可以直接解出闭式解);平方对大误差惩罚更重,模型会更努力地避免离谱的预测——代价是对离群值敏感,这是后面要处理的坑。
上手:10 行代码跑起来
# example: regression-setup
import numpy as np
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error, r2_score

# 造一份带噪声的房价数据:面积、房龄、楼层 → 价格
rng = np.random.default_rng(42)
n = 500
X = np.column_stack([
    rng.uniform(50, 150, n),     # 面积
    rng.uniform(0, 30, n),       # 房龄
    rng.integers(1, 33, n),      # 楼层
])
y = 3.5 * X[:, 0] - 1.2 * X[:, 1] + 0.3 * X[:, 2] + rng.normal(0, 10, n)

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)

model = LinearRegression()
model.fit(X_train, y_train)

y_pred = model.predict(X_test)
print(f"系数: {model.coef_}, 截距: {model.intercept_:.2f}")
print(f"RMSE: {mean_squared_error(y_test, y_pred) ** 0.5:.2f}")
print(f"R²: {r2_score(y_test, y_pred):.3f}")
这是合成数据,系数应接近生成时设定的 [3.5, -1.2, 0.3]。在其他列不变时,面积每增加一单位,模型预测增加约 3.5 个目标单位。真实数据中的回归系数首先是条件关联,不是扩建一平米必然涨价的因果证据;单位、遗漏变量和共线性都影响解释。
R² 到底在说什么
(决定系数)的定义:
这里的均值是本次评估集真实目标的均值。目标非常数时,R²=1 表示完美预测;0 表示平方误差与这个常数参考相同;负数表示更差。评估集均值在部署时不可知,另应报告“只预测训练目标均值”的可部署基线。负 R² 需要排查切分、噪声和分布变化,不宜仅凭一个数判定原因。
RMSE 是误差平方均值的平方根,与目标同单位,不是平均绝对误差 MAE。例如误差为 0 和 10,MAE=5,RMSE≈7.07。R² 提供相对尺度,但也不能代替业务容忍度与基线。目标为常数时分母为零;sklearn 默认 force_finite=True 将完美/不完美预测分别映射为 1/0,关闭后分别为 NaN/负无穷,见 R² 官方定义。
坑一:多重共线性——系数还能信吗
两个特征高度相关时,多个系数组合可能产生接近的预测。固定数据和求解器并不会“随机分配”,但轻微数据扰动就可能让系数大变。同分布预测有时仍稳定;相关关系一旦改变,预测也可能变差,不能承诺预测能力不受影响。
检测方法:
# example: regression-vif
from statsmodels.stats.outliers_influence import variance_inflation_factor
from statsmodels.tools.tools import add_constant
import pandas as pd

X_df = pd.DataFrame(X_train, columns=["面积", "房龄", "楼层"])
design = add_constant(X_df, has_constant="add")
vif = pd.DataFrame({
    "feature": X_df.columns,
    "VIF": [variance_inflation_factor(design.values, i + 1) for i in range(X_df.shape[1])],
})
print(vif)
VIF 衡量一列被其余所有列线性解释的程度,并非只检测某一对特征。上面辅助回归保留截距,但不报告截距的 VIF。10 是经验警戒线,不是自动删列标准;完全共线时可能无穷大。删冗余列、重定义特征或使用岭回归都需在训练内部验证。
坑二:过拟合与正则化
特征多、数据少的时候,线性回归也会过拟合。两副解药:
# example: regression-regularization
from sklearn.linear_model import Ridge, Lasso
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

# 岭回归(L2):惩罚系数平方和,把系数压小但一般不压到 0
ridge = make_pipeline(StandardScaler(), Ridge(alpha=1.0))
ridge.fit(X_train, y_train)

# Lasso(L1):可能得到零系数,但零不等于业务上无作用
lasso = make_pipeline(StandardScaler(), Lasso(alpha=0.1))
lasso.fit(X_train, y_train)
Ridge 按数据矩阵的不同方向收缩,并非每个原始系数同比例变小;Lasso 可以产生零系数,但相关特征之间的选择可能不稳定。现在系数对应标准化后的列,不能直接按原始单位解读。若做特征选择,也必须放在各训练折内部。
alpha 控制惩罚力度,越大约束越强。无惩罚时直接用 LinearRegression,不建议把 Lasso 的 alpha 设为 0 求解。上述 Pipeline 可用 ridge__alpha / lasso__alpha 搜索;只看训练内部 CV。
坑三:世界不是线性的
真实关系经常不是直线:房价和面积可能是对数关系,学习时间和成绩是边际递减。两个应对:
特征变换:对特征或标签取 log、开方,把非线性关系”掰直”:
# example: regression-log
if np.any(X[:, 0] <= 0) or np.any(y <= 0):
    raise ValueError("本例的 log 变换要求面积与目标严格为正")
X_with_log = np.column_stack([X, np.log(X[:, 0])])  # X 是数组,不是 DataFrame
y_log = np.log(y)
这里只构造另一组候选表示,不覆盖前文模型。逐点取 log 不估计统计量,但变换选择仍只能依据训练/验证数据。对数目标预测取 exp 后不自动等于原尺度条件均值;若要做重变换偏差校正,校正参数也不能从测试集估计。
多项式特征:给模型加上特征的平方项、交互项:
# example: regression-polynomial
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.pipeline import Pipeline

pipe = Pipeline([
    ("poly", PolynomialFeatures(degree=2, include_bias=False)),
    ("scaler", StandardScaler()),
    ("model", Ridge(alpha=1.0)),     # 本例选择正则;强度需在训练内部验证
])
pipe.fit(X_train, y_train)
degree=2、无常数列时,3 个特征变成 9 个。展开可能放大尺度差异和过拟合风险,因此本例选择展开后标准化再加正则;这不是所有数据上的强制规则,阶数与 alpha 仍需验证。
坑四:离群值绑架模型
平方误差的代价前面说了:一个 100 倍偏离的点,对损失的影响是普通点的一万倍。一套汤里的老鼠屎。处理顺序:
- 先画图:
plt.scatter(X[:, 0], y)一眼看到离谱的点。 - 查原因:先核对原始记录与单位,不能仅因数值大就删。确认错误后修正或按预先约定排除;合法极端样本可能需要保留、分层或变换。
- 比较稳健回归:RANSAC 或 Huber 可减轻部分离群点的影响,但并非对所有高杠杆点都稳健,也需训练内部验证。
模型诊断:残差是最好的老师
固定方案后可画最终残差图。若看完图继续修改模型,这个测试集就已成为开发依据,不能再把重测分数当独立验收;开发期应看验证残差。
import matplotlib.pyplot as plt

residuals = y_test - y_pred
plt.scatter(y_pred, residuals, alpha=0.5)
plt.axhline(0, color="red", linestyle="--")
plt.xlabel("预测值"); plt.ylabel("残差")
健康的残差图应该像一团没有结构的云,随机散布在 0 附近。如果出现规律,模型就在”报警”:
- 喇叭形(预测值越大残差越大):误差方差非常数,对标签取 log 试试。
- U 形/曲线形:关系是非线性的,加多项式特征。
- 几个点特别远:离群值,回到坑四。
踩坑排查清单
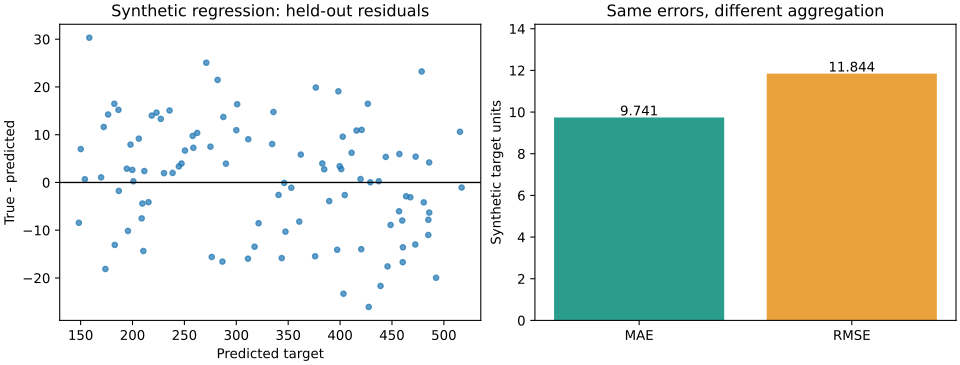
图来自本文的 500 条合成记录与固定 80/20 划分。左图是 100 条预留样本的残差,右图比较同一组误差的两种聚合;不是房价业务结果,也不据此重新调参。复跑 python examples/blog/review-ml-foundations.py,脚本执行本文标记代码块,并输出逐条残差 CSV和版本及断言。
| 症状 | 原因 | 处理 |
|---|---|---|
| 系数符号和业务直觉相反 | 多重共线性 | 查 VIF,删/合并相关特征或用岭回归 |
| 训练 R² 高、测试 R² 崩 | 过拟合或泄漏 | 加正则;检查是否有特征泄漏 |
| 测试集 R² 为负 | 模型比猜均值还差 | 检查数据质量、特征有效性、是否欠拟合 |
| Lasso 把系数全压成 0 | alpha 太大 | 对数刻度搜更小的 alpha |
| 多项式后训练极慢/报错 | 特征爆炸 + 尺度失衡 | 降 degree、加 StandardScaler |
| 预测房价出现负值 | 线性模型外推 | 对标签取 log(保证 exp 回来非负) |
练习
- 在加州房价数据集(
fetch_california_housing)上训练线性回归,报告 RMSE 和 R²,并画出残差图诊断。 - 在训练部分计算含截距的 VIF,检查一列与其余列的线性依赖,再用训练内部 CV 比较保留与删列;不要按最终测试分数决定删谁。
- 对比 LinearRegression、Ridge、Lasso 在相同数据上的 5 折交叉验证分数,并用 GridSearchCV 找出两个正则模型的最优 alpha。
- 用
PolynomialFeatures(degree=2)+ Ridge 重做一次,对比 R² 提升幅度和训练耗时。
面试常问
Q:线性回归的基本假设有哪些? 先区分拟合与推断:计算最小二乘不要求误差正态;设计矩阵满列秩使系数解唯一。解释无偏性通常要求条件均值设定正确且误差条件均值为零;经典方差公式还依赖同方差、误差不相关等条件。正态假设用于经典有限样本推断,而非“能否训练”。残差图能提示问题,不能证明这些假设成立。
Q:L1 和 L2 正则的区别,为什么 L1 能产生稀疏解? 二维直觉下,L1 约束是带尖角的菱形,最优解可能落在坐标轴上,得到零系数;L2 约束是圆形,通常不产生稀疏解。收缩并非各原始系数同比例变化,Lasso 选中哪一个相关特征也未必稳定。
Q:R² 高就代表模型好吗? 不一定。对同一批数据、相同截距设置、嵌套特征集合的无正则最小二乘,新增列不会增大最优训练平方误差;这不适用于一般正则模型,更不保证验证 R² 提高。应比较训练内部 CV 和最终独立评估。
Q:什么场景下你会放弃线性回归? 特征与标签明显非线性且变换无法掰直;特征数量远超样本量且需要强非线性交互;对预测精度要求极高且不需要解释性。这些场景换树模型(随机森林、梯度提升)或神经网络。
Q:为什么线性回归对特征尺度敏感? 可逆列缩放下,无正则最小二乘的预测理论上不变,数值精度除外。Ridge/Lasso 分别惩罚系数平方和/绝对值之和,缩放会改变惩罚的实际含义,通常应配合标准化;若特意按原始单位设定惩罚,需明确记录理由。
线性回归吃透了,下一篇换口味,看一个完全不需要”线性假设”的模型:决策树:会提问的模型,可解释性的天花板。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。