
如果说线性回归是”算出来”的模型,决策树就是”问出来”的模型:它像玩二十个问题游戏一样,不断提问——“面积大于 90 平吗?""房龄小于 10 年吗?“——几个问题之后给出答案。每个问题对应树的一次分裂,答案走到叶子节点就是预测结果。
树通常无需标准化,并能展示单个预测经过的阈值路径。这说明模型如何得到输出,不证明规则具有因果意义,也不能替代业务适用性、偏差和可靠性审查。
前置阅读:机器学习基础与 Scikit-learn。本篇是小系列第 3 篇,上一篇是线性回归。
树怎么决定”先问哪个问题”
核心思想:每次分裂选那个让数据”变纯净”最多的问题。纯净度的度量有两种:
基尼不纯度(Gini):按节点类别比例独立、有放回地抽两次,类别不同的概率。纯节点为 0;二分类五五分时最大为 0.5,k 类均匀分布时最大为 1−1/k。
信息增益(基于熵):熵衡量混乱程度,信息增益 = 分裂前的熵 − 分裂后两个子节点的加权熵。增益越大,这个问题越有价值。
实际使用中两者效果差异很小,Gini 计算更快(不用算对数),是更常见的默认。分裂过程是贪心的:每一步只看当前最优,不保证全局最优——这是树容易过拟合的根源之一,后面细说。
上手:训练一棵树并把它画出来
# example: tree-setup
from sklearn.datasets import load_wine
from sklearn.tree import DecisionTreeClassifier, export_text, plot_tree
from sklearn.model_selection import train_test_split
import matplotlib.pyplot as plt

X, y = load_wine(return_X_y=True, as_frame=True)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 先限制深度,便于检查规则;是否过拟合还要看验证表现
tree = DecisionTreeClassifier(max_depth=3, random_state=42)
tree.fit(X_train, y_train)

print(f"训练集: {tree.score(X_train, y_train):.3f}")
# 暂不读取测试分数;下方用训练内部 CV 选定深度后再评估。

# 文字版决策规则:可以直接贴给业务方看
print(export_text(tree, feature_names=list(X.columns)))
export_text 的输出长这样(示意):
|--- alcohol <= 12.37
|   |--- malic_acid <= 1.65
|   |   |--- class: 1
...
每一条缩进路径就是一条“如果……那么……”规则。解释某个预测时,沿该样本经过的路径读即可;同时应报告叶子里有多少训练样本。只有一两个样本支撑的规则,即使看起来直观,也不一定可靠。
树长得更深,为什么未必更好
取消深度限制后,树可以用更细的规则拟合训练样本,包括噪声。训练分数可能上升,但验证分数是否下降取决于样本量、噪声和真实边界,不能预先写成必然结果。如果训练与验证表现差距扩大,再考虑缩小树;两边都差时,继续剪枝反而可能加重欠拟合。
控制规模时,可以从深度和叶子最小样本数开始,再比较剪枝参数。下面参数只是候选配置,不是 wine 数据集的最优结果:
# example: tree-pruning
tree = DecisionTreeClassifier(
    max_depth=5,              # 最多问 5 层问题(最重要)
    min_samples_leaf=5,       # 叶子至少 5 个样本,防"一个样本一个叶子"
    min_samples_split=20,     # 节点少于 20 个样本就不再分裂
    ccp_alpha=0.01,           # 代价复杂度剪枝:后剪枝,砍掉贡献小的分支
    random_state=42,
)
tree.fit(X_train, y_train)    # 重新创建模型后,需要重新训练
max_depth 和 min_samples_leaf 在生长过程中限制复杂度;ccp_alpha 则在拟合误差与树规模之间做权衡。参数应在训练数据内部用验证集或交叉验证选择,不要每调一次就查看测试集。
特征重要性:解释模型用了什么,不是证明因果
训练完直接问模型”哪些特征重要”:
import pandas as pd

importance = pd.Series(tree.feature_importances_, index=X.columns)
print(importance.sort_values(ascending=False).head(10))
计算方式:各特征分裂贡献的加权不纯度下降,通常归一化到和为 1;若树完全不分裂,重要性全部为 0。这个数有两个已知偏见:
- 偏爱取值多的特征:连续特征和高基数类别特征(比如”用户 ID”这种)可切的位置多,容易被高估。
- 相关特征可互相替代:重要性可能被分摊,也可能大部分落在先被选中的一列,不能按低重要性断定某列没有信息。
做特征筛选时,重要性只是个参考信号,别当成圣旨。
树不擅长的三件事
了解边界比了解优势更重要:
斜的决策边界。 树的分裂是”一刀切”——只能沿某个特征垂直/水平切。如果真实边界是 x1 + x2 > 5 这种斜线,树要用很多阶梯状的切分去逼近,效率很低。这是线性模型反而更合适的场景。
外推。 默认平方误差回归树输出叶子内目标值的均值,所以预测值落在训练目标的范围内。它可以输出某个训练样本从未出现过的均值,但不会沿趋势预测到训练目标范围之外。不要把“不能外推”误解为“只能返回某条旧记录”。
不稳定。 数据轻微变化可能改变首次分裂乃至后续结构。随机森林通常结合样本自助抽样和每个节点分裂时抽取候选特征,再聚合多棵树,缓解单树方差;不是简单规定每棵树永远只能看某几列。
回归树:预测数值也行
默认平方误差回归树按目标值的离散程度选择分裂,叶子输出均值。这里换成连续目标数据,不能沿用前面 wine 的类别编号来解释回归:
# example: tree-regression
from sklearn.tree import DecisionTreeRegressor
from sklearn.datasets import load_diabetes

X_reg, y_reg = load_diabetes(return_X_y=True)
Xr_train, Xr_test, yr_train, yr_test = train_test_split(
    X_reg, y_reg, test_size=0.2, random_state=42
)
reg = DecisionTreeRegressor(max_depth=4, min_samples_leaf=10, random_state=42)
reg.fit(Xr_train, yr_train)
print("测试集 R²:", reg.score(Xr_test, yr_test))
前面讲的所有坑(过拟合、不能外推、不稳定)对回归树同样成立。
实测:选深度不看测试集,外推单独检验
下面接在 wine 示例之后。之前的两个手设配置仅演示 API,不按它们的测试表现决定参数;这里预先固定候选深度,在训练部分五折比较:
# example: tree-selection
from sklearn.model_selection import GridSearchCV, StratifiedKFold
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
depth_search = GridSearchCV(
    DecisionTreeClassifier(random_state=42),
    {"max_depth": [1, 3, 5, 10, None]},
    scoring="f1_macro", cv=cv, return_train_score=True,
)
depth_search.fit(X_train, y_train)
selected_tree = depth_search.best_estimator_
final_prediction = selected_tree.predict(X_test)  # 参数锁定后一次预测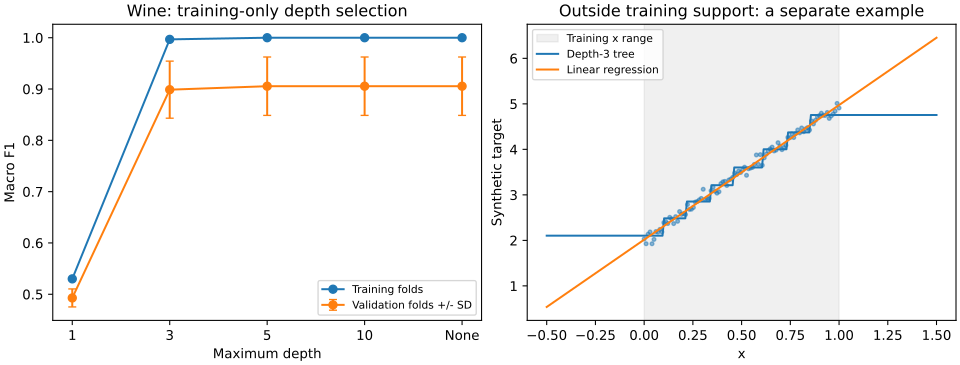
左图不是“深度—测试分数”图:每个点只来自 142 条训练样本内部的五折,误差线是折间标准差。最深树不一定最差,不能强行寻找过拟合拐点。最终 36 条预留样本只评估选定配置。
右图是独立的合成实验:仅用 x∈[0,1] 的含噪直线训练,画到 [-0.5,1.5]。回归树输出受训练目标值域限制,边界外成为平台;直线会继续延伸,但只有真实机制保持线性时这种外推才可能合理。不能把“能外推”当作“外推准确”。
复跑 python examples/blog/review-ml-foundations.py;脚本执行本文标记代码块,并保存五折搜索表及结果与环境。剪枝配置只做运行检查,未宣称其最优;机制边界另见 官方树模型说明。
踩坑排查清单
| 症状 | 原因 | 处理 |
|---|---|---|
| 训练 100% 测试大跌 | 没限制树规模 | max_depth + min_samples_leaf |
| 每次训练树长得不一样 | 没设 random_state / 数据轻微变化 | 固定种子;认识树的天然不稳定性 |
| 新数据预测全是旧值域 | 树不能外推 | 外推需求换线性模型 |
| 某特征重要性高得离谱 | 高基数特征被偏爱(如 ID 列) | 删掉 ID 类特征重训 |
| 模型在边界附近频繁出错 | 真实边界是斜的 | 尝试特征组合或换线性模型 |
| 画图中文乱码/看不清 | matplotlib 字体与图太大 | 用 export_text 替代,或调 figsize/dpi |
练习
- 用上面的训练内部 CV 曲线选择深度,再对最终配置评估一次测试集;解释为什么不能画多条测试分数后择优。
- 用训练数据生成
ccp_alpha候选值,在训练部分做交叉验证选择 alpha,最后才使用测试集。说明为什么不能按测试分数挑参数。 - 构造一份含高基数 ID 类特征的数据,观察它对特征重要性的污染,再删掉重训对比。
- 重跑合成外推实验,再把区间外真实机制改为弯曲关系,观察直线为何也会失败。区间内极端值预测差并不足以证明外推机制。
放进贯穿项目:解释哪些论文需要人工复核
可以把浅树作为论文入库复核的基线:用缺失字段数、文本长度、来源类型等入库时已有的信息,预测人工标注的“需要复核”。这里必须有明确标签,不能把自定规则生成的标签当作独立的人工判断,再宣称模型验证了规则有效。
作品集展示一条完整决策路径,并附上该叶子的样本量、误报和漏报案例。若某个来源几乎总被判为需复核,要检查它是否只是历史标注偏差。规则易读,不代表规则合理。
面试常问
Q:决策树为什么不需要特征标准化? 单列阈值切分主要依赖排序,标准化这种线性缩放通常不会改变分区。但浮点精度和并列候选可能影响结果;非线性单调变换还可能改变训练点间的阈值位置,使新样本路由不同。因此无需常规标准化不等于任意变换下预测严格一致。
Q:信息增益和基尼不纯度有什么区别? 数学上都度量节点不纯度,实践中效果接近。Gini 无对数运算、更快,是 sklearn 默认;信息增益有信息论解释。知道有区别即可,实际选型不是关键决策。
Q:决策树为什么容易过拟合,怎么控制? 贪心分裂 + 无限生长 = 可以为每个训练样本定制叶子,把噪声也学进去。控制手段:限制深度、限制叶子/分裂最小样本数(预剪枝)、ccp_alpha 代价复杂度剪枝(后剪枝),或者干脆用集成方法(随机森林、梯度提升)。
Q:树模型对缺失值怎么处理? 需要看版本和具体配置,不能笼统回答“不支持”。当前 Scikit-learn 的部分树配置支持 NaN,而类别字符串仍需编码。使用前按所安装版本核对 决策树官方文档;若采用填充方案,填充值只能在训练集上估计。
Q:决策树和线性模型怎么选? 需要检查分段规则时,可以从浅树开始;关系近似线性、希望表达连续趋势时,可以先试线性模型。Scikit-learn 决策树并不能免去类别编码。比较时使用相同的数据划分,同时检查误差、规则规模和业务约束,而不是只比较一个分数。
树讲完了,监督学习的三个基础模型就齐了。下一篇换个世界——没有标签时模型还能干什么:K-Means 聚类:让数据自己抱团。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。