
异常检测经常面对正常样本多、异常样本少的问题。有时能得到部分异常标签,有时只能先描述正常数据的分布,再找偏离明显的样本。下面分别讨论这些条件下的建模方式,也会解释为什么异常分数高并不自动等于发生故障。
这篇讲三条主流路线(孤立森林 / One-Class SVM / AutoEncoder)、时序场景的特殊处理,以及最头疼的「没标签怎么评估」。
前置阅读:建议先读 模型评估指标与类别不平衡、K-Means 聚类、时间序列分析。
先划边界:什么时候用异常检测而不是分类
| 情形 | 选择 |
|---|---|
| 有足够异常标签(几百+)且模式稳定 | 监督分类(不平衡处理即可) |
| 异常极少、模式多变、新异常不断出现 | 异常检测 |
| 完全无标签,只要「最可疑的 top-N」 | 异常检测(排序用法) |
现实项目常是混合:异常检测做初筛排序 → 人工审核积累标签 → 标签够了转监督。评估与不平衡那篇讲的是后者,这篇讲前者。
孤立森林:一个便于检查的基线
原理:异常点更容易被「孤立」
随机选特征、随机选切分点,递归切分直到每个样本被孤立——异常点孤僻,几刀就被切出来;正常点抱团,要切很多刀。所以「平均孤立所需路径长度」就是异常分:路径越短越异常。
from sklearn.ensemble import IsolationForest

iso = IsolationForest(
    n_estimators=200,
    contamination=0.02,      # 预估异常比例,决定阈值
    random_state=42)
iso.fit(X_train)             # 注意:训练集应基本为正常样本

scores = -iso.score_samples(X_test)   # 越大越异常
preds = iso.predict(X_test)           # -1 异常 / 1 正常
contamination 用于确定训练分数的切分阈值,不保证新数据也恰好报出该比例,更不是估计真实异常率的工具。200 棵树只是起点,需检查不同种子下分数稳定性。孤立森林可以用于含少量异常的离群点检测;若采用“只学正常、检测新样本”的协议,要明确正常训练集的来源与覆盖范围。
训练成本与树数和每树抽样量有关,不宜简单概括为对所有输入线性。无关特征很多时,随机切分仍会浪费在无用维度上;不做距离计算不等于免疫高维问题。
One-Class SVM:学一个包住正常的边界
思想:在高维空间找一个超平面/超球,把绝大多数正常样本包在内部,外面的就是异常(支持向量数据描述 SVDD 的近亲)。
from sklearn.svm import OneClassSVM
from sklearn.pipeline import make_pipeline
from sklearn.preprocessing import StandardScaler

ocsvm = make_pipeline(StandardScaler(), OneClassSVM(kernel="rbf", nu=0.02, gamma="scale"))
ocsvm.fit(X_train)
preds = ocsvm.predict(X_test)
nu 的定义是训练误差比例的上界、支持向量比例的下界,不是测试异常率上界,也不与 contamination 等价。RBF 核对尺度敏感,示例把 StandardScaler 放入流水线,仅在训练数据拟合。数据规模与核矩阵会影响成本,但不能用“1 万条”作为普适淘汰线。OneClassSVM 参数定义
AutoEncoder:用重构误差检测异常
一种路线是只用正常样本训练压缩与重建网络,再把重构误差作为异常分数。但网络也可能重建某些异常,所以误差大并非异常的必要条件。阈值需要结合正常样本分布、已知异常和人工复核成本来选择。
import torch
import torch.nn as nn

class AE(nn.Module):
    def __init__(self, dim, hidden=32):
        super().__init__()
        self.enc = nn.Sequential(nn.Linear(dim, 64), nn.ReLU(), nn.Linear(64, hidden))
        self.dec = nn.Sequential(nn.Linear(hidden, 64), nn.ReLU(), nn.Linear(64, dim))
    def forward(self, x):
        return self.dec(self.enc(x))

model = AE(dim=X_train.shape[1])
# 只用正常样本训练,loss = MSE(重建, 原样本)
# 推理:anomaly_score = ((model(x) - x) ** 2).mean(dim=1)阈值应优先从未参与模型拟合的正常校准集确定;训练误差通常偏低,直接取其 99 分位数容易低估新正常样本误差。校准分位数只是选阈值的方法,不自动保证未来误报率,尤其在分布漂移时。推理需 model.eval() 与 torch.no_grad();示例只定义了结构,没有完整训练循环,不能据此比较 AutoEncoder 与孤立森林的胜负。
变体:VAE 用重构概率、GANomaly 用判别器特征差——思想同根,工程复杂度递增。
时间序列异常:另一个物种
表格异常检测假设样本独立,时序数据违反这个假设。时序异常分三种,处理思路不同:
- 点异常:单个点离谱(温度传感器突跳到 500°C)——滚动窗口统计:偏离 rolling mean ± 3σ 即报。
- 上下文异常:数值本身正常但出现时机不对(凌晨三点的大额交易)——必须带时间特征(hour/dow)再检测。
- 集合异常:一段序列的模式异常(波形形状变了)——需要序列级方法:LSTM 预测误差、STL 分解后看残差。
# 观测到当前点后,与此前窗口比较;不使用当前点或未来值拟合基线
import pandas as pd

def causal_zscore(series, window=48):
    if window < 2 or not series.index.is_monotonic_increasing or series.index.has_duplicates:
        raise ValueError('窗口至少为2,时间索引必须升序且唯一')
    roll = series.shift(1).rolling(window=window, min_periods=window)
    scale = roll.std(ddof=1).replace(0, float('nan'))
    return (series - roll.mean()) / scale

z = causal_zscore(series)
anomalies = series[abs(z) > 3]
旧示例的 center=True 会查看未来值,不适合实时告警。现在用过去 48 点建立基线;前 48 点和零方差窗口返回 NaN,调用方必须明确“历史不足/基线恒定”的状态,不能把未评分默认为正常。3σ 也不是在任意分布、相关序列或反复检验中都具有固定误报率。
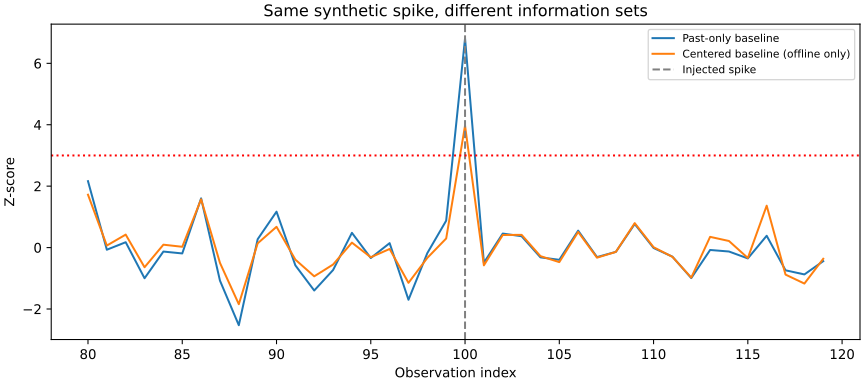
脚本修改未来数据后,断言过去分数保持不变;同时证明居中窗口会改变较早分数。时间序列篇里的离线分解也有相同的可用时间问题,直接把全序列 STL 残差当作在线输入会泄漏。
实跑:模型、阈值与测试分开
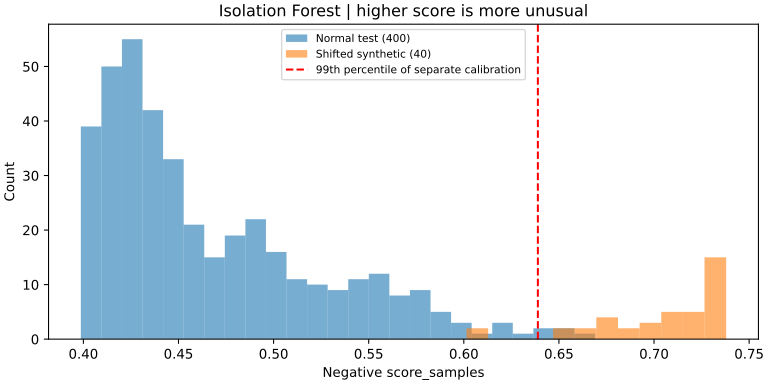
三份数据分别用于模型拟合、正常分数 99 分位校准、最终评估。异常仅为人为偏移的二维点,图中分离度不代表真实故障检出率。脚本还在固定种子下比较两个 contamination:原始分数相同,decision threshold 改变。完整阈值、混淆计数、Precision@K 和环境见 结果 JSON。
本次 400 个正常测试点中误报 3 个,40 个偏移点中检出 38 个;该有限样本结果不是未来误报承诺。复跑入口为 review-model-validation.py,分数与 offset 的关系见 IsolationForest 官方说明。
无标签怎么评估:诚实面对灰色地带
这是异常检测最难的部分,几种现实策略:
- 审核 top-K:要算 Precision@K,必须审核这 K 条中的真异常与正常样本,不能只拿一批已知异常作分母。只审核高分样本会产生选择偏差,不能据此估计全量召回率。
- 合成异常:往正常数据里注入扰动造伪异常(特征打乱、极端值),测检出率。注意合成异常≠真实异常,只能相对比较不同方法。
- 稳定性检验:不同时间窗的异常率是否稳定——某天异常率突然 10 倍,先查数据管道再查模型。
- 人工抽检:随机抽模型判「最正常」的样本让人看——如果里面混着明显异常,模型在漏报。
有可靠标注的测试集时,可以定量评估召回、精确率和误报率;未知异常覆盖不足时,再辅以抽样审核与上线监控。问题不在于异常检测不能量化,而在于测试集覆盖了哪些异常。
组合方案示意:排序与人工回流
孤立森林(快筛,全量打分)
   + 规则引擎(黑名单、确定性规则,抓「已知异常」)
   + 业务特征上的统计告警(时序滚动 Z-score)
   → 三路分数加权排序 → top 500/天 → 人工审核
   → 审核结果回流 → 按标签覆盖与稳定性决定是否增加监督分类
这是设计示意,不是已部署业务记录。三路分数的尺度不同,不能未经校准直接相加;审核容量也要按实际人力确定。回流记录应保留抽样策略、时间和不确定标签,同时随机审核部分低分样本,避免模型只学到自身偏好的样本。
踩坑排查
| 现象 | 原因 | 解法 |
|---|---|---|
| 孤立森林报的「异常」全是某类正常用户 | 训练集本身含多类正常模式 | 先分群再分别检测;或检查特征是否该保留 |
| contamination 设 1% 新数据报出 15% | 可能是分布变化、数据处理差异或训练覆盖不足 | 对比分数分布和管道;不能直接断定训练被污染 |
| One-Class SVM 全员异常 | 特征没缩放,距离失真 | StandardScaler 是 OCSVM 的前置条件 |
| AutoEncoder 异常分不出层 | 可能容量过大、特征无区分度或训练污染 | 比较独立正常/已知异常的误差;训练误差更小不等于检测更好 |
| 白天告警少凌晨告警爆 | 没用上下文特征 | 加 hour/dow,或分时段建模 |
| 上线后异常率逐月漂移 | 正常模式本身在演化 | 定期用新数据重训(滚动窗口) |
练习
- 在 sklearn 的
make_blobs数据上注入 2% 偏移点,对比孤立森林 / OCSVM / 3σ 三者的 Precision@20。 - 对一份带时间戳的指标数据,实现滚动 Z-score 检测,调 window 和阈值,观察误报率变化。
- 用 AutoEncoder 在 MNIST 上玩「留一类」:训练时只给数字 0,测试时对比 0 和 8 的重构误差分布——画出直方图看分离度。
- 设计一个「无标签评估方案」:假设你只能请业务专家看 100 条/天,写出完整的一周评估计划。
面试常问
Q:孤立森林为什么对高维友好? 每个切分节点选择一个特征,而不是整棵树只用同一维。它不直接用成对距离,但大量无关维度仍可稀释有用切分;应通过特征与抽样设置的对照实验判断效果。
Q:AutoEncoder 检测异常的前提假设? 「异常样本在训练分布之外,所以重建不好」。失效场景:① 异常和正常长得太像(重构误差分离不开);② 模型容量过大,连没见过的异常也能重建(恒等映射风险);③ 训练集本身混入了异常(把异常也学了)。所以瓶颈维度和训练集洁净度是两个命门。
Q:异常检测怎么设阈值? 可用审核容量确定 top-N,或用独立正常校准集的高分位数选阈值;有代表性标签时,再结合误报与漏报成本选择。不要把某个行业比例当作通用先验;阈值变更需要版本与评估记录。
Q:和监督分类的本质差异是什么? 监督分类利用已知标签学习决策边界;异常检测可以通过密度、隔离、距离或重构建立异常分数,不都要求只有正常样本。两者对未见模式都可能失败,不能保证异常检测天然更鲁棒;应按目标异常、审核成本与代表性测试数据比较。
Q:怎么处理「正常」本身在缓慢变化? 先检查采集与特征管道,再结合标签判断是否漂移。渐变可能是缓慢故障,突变也可能是正常版本切换,不能只按变化速度定性。重训窗口、旧样本权重和回滚条件应版本化,防止把持续异常吸收到新的“正常”中。
相关阅读
- 模型评估指标与类别不平衡——标签攒够之后的下一站
- K-Means 聚类实战——基于距离的异常检测思想
- 时间序列分析实战——时序异常的分解工具
- 自监督学习入门——「只学正常」思想的现代表达
- MLOps:实验跟踪与监控——异常检测在监控告警中的应用
异常分数只说明相对模型的偏离。最后要回答的是:这个阈值在什么数据上校准、每天需要审核多少条、已知异常能覆盖多少,以及遇到新分布时如何暂停自动判断。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。