
前面三篇都是监督学习——有标签、有老师。这篇进入无监督学习:数据没有标签,让算法自己发现结构。K-Means 是这个世界的入门砖:给用户分群、给文档分组、给图像压缩颜色,都能用它起步。
以用户分群为例,没有“高价值用户”标签时,可以先按消费频次、客单价和活跃程度观察分组。但模型不会替你定义高价值:选哪些特征、怎样缩放,已经带入了业务判断。聚类给出的是待验证的分组,不是自动发现的用户真相。
前置阅读:机器学习基础与 Scikit-learn。本篇是小系列第 4 篇(收官篇),前三篇:线性回归、决策树。
算法逻辑:两步轮流做,做到不动为止
K-Means 的目标:把 个点分成 团,使每个点到自己那团中心(质心)的平方距离之和最小:
这个目标函数叫惯性(Inertia)。算法实现出奇朴素,两步交替:
- 分配:每个点归入离它最近的质心那一团。
- 更新:每团的质心移到团内所有点的均值位置。
重复到质心不再移动(或移动小于阈值)。看代码也就十几行:
# example: clustering-setup
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
import numpy as np

# 教学构造数据:消费频次、客单价、距最近一次活跃的天数
X = np.array([[12, 300, 2], [1, 50, 40], [15, 280, 1], [2, 80, 35],
              [11, 320, 3], [3, 60, 30], [14, 290, 2], [1, 70, 45]])

scaler = StandardScaler()
X_scaled = scaler.fit_transform(X)   # 保存此缩放器,新样本不能重新 fit

km = KMeans(n_clusters=2, n_init=10, random_state=42)
labels = km.fit_predict(X_scaled)

print(labels)            # 每个点属于哪团
print(km.cluster_centers_)  # 各团质心(标准化后的坐标)
print(km.inertia_) # 惯性,越小抱得越紧算法可能因容差或迭代上限而停止,并不保证达到全局最优。初始中心会影响结果,因此要记录初始化、n_init、tol 和 max_iter,而不只记 K。
关键动作一:先决定距离应该表示什么
K-Means 使用到中心的欧氏距离平方。上面客单价为 50–320,频次为 1–15,沉默天数为 1–45;原始单位下金额差异可能占据更大距离贡献,但不能不计算就断言其他列完全不起作用。
标准化把各列调整到单位方差,能减少数值尺度差异,但不保证各列具有相同的业务价值。若坐标本来使用同一单位,或某列确实需要更高权重,就未必该逐列标准化。长尾金额还可能先做对数变换。先确定距离的含义,再选择缩放方法;不要把 StandardScaler 当成固定仪式。
关键动作二:K 值怎么选
K 决定分组数量;初始化、重启次数和停止条件也会影响结果。选 K 时可以先比较两类信号:
肘部法则(Elbow):画 K 从 1 到 10 的惯性曲线,找”拐点”——拐点之前惯性下降很快(每加一个团收益大),之后变平(再加收益小)。
# example: clustering-candidates
from sklearn.metrics import silhouette_score
import matplotlib.pyplot as plt

Ks = range(2, min(9, len(X_scaled)))  # 8 条数据最多评估到 K=7
inertias, silhouettes = [], []

for k in Ks:
    candidate = KMeans(n_clusters=k, n_init=10, random_state=42).fit(X_scaled)
    inertias.append(candidate.inertia_)
    n_labels = len(np.unique(candidate.labels_))
    silhouettes.append(
        silhouette_score(X_scaled, candidate.labels_)
        if 2 <= n_labels < len(X_scaled) else np.nan
    )
**轮廓系数(Silhouette)**同时考虑团内距离和团间距离,适合辅助比较,但不是真实分组的答案。其取值范围是 [-1, 1],较高值表示在所选距离下组内更紧、组间更远。特别注意:实际标签数必须介于 2 和样本数减 1 之间。上面的 8 条数据若分成 8 个簇,就无法计算这个指标。定义与边界条件见 Scikit-learn 官方说明。
这 8 条记录只适合演示 API,不能据此认定业务应分两群。惯性和轮廓系数需要结合重采样稳定性、最小群规模及业务验证;不同缩放改变了距离几何,不能仅按分数高低决定哪个表示更正确。候选循环用 candidate,不会覆盖前文 K=2 的 km。
关键动作三:理解 n_init 和 K-Means++
n_init=10 表示运行 10 次初始化并返回惯性最小的结果;它增加计算量,也不保证找到全局最优。
经典 K-Means++ 按到最近已有中心的距离平方加权选后续中心。sklearn 实现采用每步尝试多个候选的 greedy 变体,通常是合理起点,但不能保证每份数据上更快或更稳。实现与停止条件见 KMeans 官方参数说明。
K-Means 搞不定的形状
K-Means 最小化到质心的平方距离,因此通常更适合紧凑、尺度相近的分组。“球状簇”是理解其偏好的直觉,不是算法要求每个真实簇严格满足的分布假设。遇到以下结构时,需要特别检查分组图和样本:
- 细长条/弯月形的团:两个嵌套的新月形,K-Means 会从中间切开,因为它只认距离最近的质心。
- 密度差异大的团:一个紧密的小团 + 一个松散的大团,小团容易被大团”吸走”边界点。
- 离群值:几个极端点会把质心拖偏。聚类前先处理离群值,或用对离群值稳健的 K-Medoids。
- 不同尺寸的团:一大一小两团,大团的边缘点可能离小团质心更近。
遇到非球形结构,可以比较 DBSCAN 或层次聚类。DBSCAN 的结果依赖距离、eps、min_samples 和密度差异;并不保证自动找到所有形状或把所有异常标成噪声。
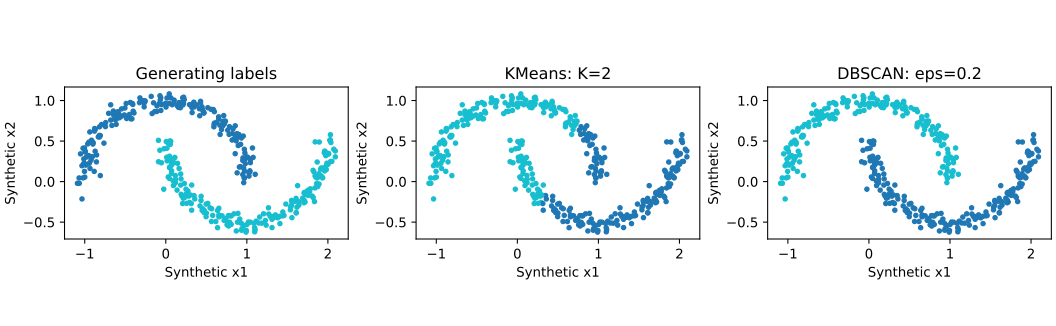
图使用 400 个双月样本、noise=0.06、种子 42;预先固定 K=2 和 DBSCAN(eps=0.2, min_samples=5),不按生成标签搜索参数。ARI 只作为这份有生成标签的教学数据的外部评价;真实无标签用户数据不能凭空计算它。颜色和簇编号没有大小关系,跨算法也没有固定语义对应。复跑 python examples/blog/review-ml-foundations.py;结果 JSON同时报告噪声数与实际簇数,不是算法排行榜。
聚类之后:结果怎么用
聚类不是终点。我的标准动作是给每团画像:把每团的特征均值拉出来对比,给团起业务名字,再验证这个分群对下游任务有没有用:
import pandas as pd

df = pd.DataFrame(X, columns=["频次", "客单价", "沉默天数"])
df["cluster"] = labels

profile = df.groupby("cluster").mean()
print(profile)
# 可能得到:第 0 团 高频高价活跃 → "核心用户"
#          第 1 团 低频低价沉默 → "流失风险用户"
若将簇信息送给监督模型,类别编号应独热编码,或使用到各中心的距离;不要把 0/1/2 当有序数值。缩放和聚类都必须在每个训练折内部拟合,不能先对全量数据聚类再交叉验证。业务上没有区分度也可能是数据本来没有稳定分组,而不一定是特征选错。
部署时复用完整变换链路。下面接在候选循环之后,仍使用原来的 K=2 模型:
# example: clustering-predict
new_users = np.array([[10, 250, 4], [2, 65, 38]])
new_labels = km.predict(scaler.transform(new_users))
centers_original_units = scaler.inverse_transform(km.cluster_centers_)
assert km.n_clusters == 2
print(new_labels, centers_original_units)
如果任务只是探索当前整批数据,允许拟合这批数据,但不要把描述性分群成绩说成新样本泛化成绩。若定期重训,应另外维护新旧簇对应关系。
踩坑排查清单
| 症状 | 原因 | 处理 |
|---|---|---|
| 聚类结果被单一特征主导 | 尺度或权重不符合任务含义 | 检查各列距离贡献,再选择缩放或权重 |
| 同样的数据每次结果不同 | 没设 random_state,初始化敏感 | 固定种子 + n_init=10 + k-means++ |
| 肘部曲线没有明显拐点 | 数据本身没有清晰的团结构 | 换轮廓系数验证;承认数据可能不适合聚类 |
| 某团只有一两个点 | 离群值自成一团 | 先清洗离群值 |
| 分出的团业务上解释不通 | 特征选择不当 | 重做特征工程,别硬调 K |
| 大量点轮廓系数为负 | K 值不合适或数据非球形 | 调 K;或换 DBSCAN/层次聚类 |
练习
- 用
make_blobs生成 4 团数据,故意让三个特征量纲差 100 倍,对比标准化前后的聚类效果和轮廓系数。 - 在 iris 数据上(只用特征、不看标签)做 K-Means,用肘部法则和轮廓系数分别选 K,对比分出的团和真实标签的重合度。
- 用
make_moons生成弯月形数据,分别跑 K-Means 和 DBSCAN,画图对比两者结果,直观理解”球形假设”的限制。 - 给聚类结果做画像:选一份真实业务风格的数据,为每团写一句业务解读,并说明这个分群能支撑什么决策。
放进贯穿项目:给论文库建立待审核主题组
将标题和摘要编码为向量后,可以先做聚类,再为每组抽取若干代表论文,请人工给出主题名。簇编号只是内部标识,0 不比 1 更重要;重新训练后编号还可能互换,不能直接把它当作稳定的业务类别。
作品集保留向量模型与预处理配置、候选 K 的比较、代表论文和不容易归组的边界样本。如果要给新论文分组,应复用已经拟合的预处理和质心;如果定期重训,则要记录新旧簇如何对应。先展示主题是否有用,再讨论轮廓系数高不高。
面试常问
Q:K-Means 的收敛性有保证吗? 理想 Lloyd 更新使目标非增且有下界,但这不是全局最优保证。实际实现可能按容差或迭代上限提前停止;停止时中心甚至未完全等于最终分配的均值。应区分目标收敛、实现停止与找到最优解。
Q:为什么 K-Means 对尺度敏感? 它使用各列差值的平方和,所以改变一列的单位,就可能改变分组。需要先检查尺度,再选择标准化、稳健缩放或业务权重;同单位坐标并不一定需要逐列缩放。
Q:怎么选 K? 没有金标准。常用肘部法则(惯性曲线拐点)和轮廓系数(内聚度 vs 分离度)取交集,最终还要业务可解释性把关:分出的群必须能起名、能对应行动,否则数学上再优也没用。
Q:K-Means 和 KNN 有什么关系? 除了名字都有 K,几乎无关。KNN 是监督学习:用邻居的标签投票做分类/回归;K-Means 是无监督学习:迭代移动质心把数据分团。面试里这是经典的”看你是否真的懂”陷阱题。
Q:数据有离群值时怎么办? 先判断异常是否为合法少数群,不按 IQR/Z-score 自动删除。K-Medoids 使用实际样本作代表点,通常比均值中心更耐受极端值,但不是免疫。DBSCAN 的 -1 表示在指定密度参数下未归簇,不等于已证明业务异常。
至此,机器学习入门小系列四篇齐了:基础流程 → 线性回归 → 决策树 → 本篇。接下来系列会转向听觉世界:语音识别:从声波到文字。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。