
我之前写过一组 OpenCV 笔记(插值、掩膜、轮廓、霍夫变换……),但”会写单个 API”和”做出一个能用的视觉应用”之间还有很大距离。这篇笔记选一个具体的小项目,把零散的技巧串成完整流程——从需求分析、方案设计到核心代码实现,帮你跨过”教程到项目”的门槛。
一、项目选题与需求分析
教程里最常见的是”识别一只猫”这种单点任务,但真实项目需要一整套流水线。我挑了硬币自动计数这个场景:贴近日常、技术点覆盖全面(预处理、形态学、轮廓、分类)、效果可量化。
输入输出定义:
- 输入:手机拍摄的桌面硬币照片(JPG/PNG,常见 4000x3000 分辨率)
- 基线输出:圆形候选数量 + 标注后的结果图;未经真实照片评估,不把每个候选自动称为硬币。
- 后续目标:有面值与尺寸标定数据后,再输出已识别金额和未知对象数量。
拟定验收目标,尚未证明达到:
- 准确率 ≥ 90%(光照正常条件下)
- 单张处理 < 1 秒(消费级笔记本 CPU)
- 支持人民币 1 元、5 角、1 角三种面值
90% 是早期项目目标,不是实测成绩。必须先定义“准确率”:逐图计数完全正确率、计数 MAE 与逐枚分类准确率应分别报告。误差不超过 1 的宽松指标可另列,但不能冒充完全正确率。
二、方案设计
处理流水线分五层:
- 预处理:灰度化 → 高斯模糊(降噪)→ 自适应阈值二值化
- 形态学操作:开运算(去噪点)→ 闭运算(填空洞)
- 轮廓检测:
findContours→ 按面积过滤 → 按圆形度过滤 - 可选分类:只对已标定的币种、版本和拍摄平面比较半径;尺寸相近、版本未知或不满足容差时拒识。
- 结果绘制:画轮廓 + 标注面值 + 显示总额
各层用到的 OpenCV 模块和我之前的笔记对应:
- 预处理里的灰度化、高斯模糊、自适应阈值——属于基础图像操作,可参考 OpenCV 几何变换与插值
- 轮廓检测和特征过滤——细节看 OpenCV 轮廓与特征提取
- 备选方案的霍夫圆变换——原理在 OpenCV 霍夫变换与亮度调整
这里以 findContours 为基线、霍夫变换为对照。反光条件下哪种更稳,需要同一测试集的漏检与误检记录,不能预设赢家。
三、核心实现
预处理 pipeline
import cv2
import numpy as np

def preprocess(img_bgr: np.ndarray) -> np.ndarray:
    # 1. 灰度化
    gray = cv2.cvtColor(img_bgr, cv2.COLOR_BGR2GRAY)
    # 2. 高斯模糊降噪(7x7 是待验证的起点,不是已证明的最优值)
    blurred = cv2.GaussianBlur(gray, (7, 7), 0)
    # 3. 自适应阈值;先检查输出是否真的形成完整前景
    binary = cv2.adaptiveThreshold(
        blurred, 255,
        cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
        cv2.THRESH_BINARY_INV,  # 仅在目标比局部背景暗的样本上考虑此方向
        blockSize=21, C=5,
    )
    # 4. 形态学:开运算去噪点
    kernel = cv2.getStructuringElement(cv2.MORPH_ELLIPSE, (5, 5))
    opened = cv2.morphologyEx(binary, cv2.MORPH_OPEN, kernel, iterations=2)
    # 5. 闭运算填空洞
    closed = cv2.morphologyEx(opened, cv2.MORPH_CLOSE, kernel, iterations=2)
    return closed
blockSize=21 是经验值,太小会过度分割硬币边缘,太大则把多个硬币黏成一团。
轮廓过滤
def find_coins(binary: np.ndarray, img_bgr: np.ndarray):
    contours, _ = cv2.findContours(
        binary, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE
    )

    coins = []
    img_area = img_bgr.shape[0] * img_bgr.shape[1]
    min_area = img_area * 0.0005  # 最小:约占图面积 0.05%
    max_area = img_area * 0.05    # 最大:约占图面积 5%

    for cnt in contours:
        area = cv2.contourArea(cnt)
        if not (min_area < area < max_area):
            continue

        peri = cv2.arcLength(cnt, True)
        if peri == 0:
            continue
        # 圆形度:4πA / P²,完美圆为 1
        circularity = 4 * np.pi * area / (peri ** 2)
        if circularity < 0.8:
            continue

        (x, y), radius = cv2.minEnclosingCircle(cnt)
        coins.append({"center": (int(x), int(y)), "radius": radius, "area": area})

    return coins
三个关键过滤条件:
- 面积范围:过小可能是噪点,也可能是真实小目标;过大可能粘连,也可能只是拍得近。
- 圆形度 ≥ 0.8:只是候选筛选条件。倾斜的硬币可能被漏掉,其他圆物体仍可能通过。
RETR_EXTERNAL:只取最外层轮廓,避免硬币内部纹理被误识别
硬币分类
def classify_coin(radius_px: float, scale: float,
                  references: dict[int, float], tolerance_mm: float) -> int | None:
    """references 为实测的 面值(分):半径(mm);歧义或不匹配返回 None。"""
    values = [radius_px, scale, tolerance_mm, *references.values()]
    if not references or not all(np.isfinite(v) and v > 0 for v in values):
        raise ValueError('半径、比例、容差与标定参考必须为有限正数')
    radius_mm = radius_px * scale
    matches = [value for value, radius in references.items()
               if abs(radius_mm - radius) <= tolerance_mm]
    return matches[0] if len(matches) == 1 else None
scale 的单位是毫米/像素,用同一平面的已知尺寸参照物标定;倾斜透视、不同高度和检测前缩放都会影响它。参考半径还要标注币种与版本。这个函数只是受限分类规则,不验证材质或图案;圆形杂物也可能匹配,不能用于可靠金额结算。当前 CLI 因没有真实标定文件而只输出候选计数。
参数调优
| 参数 | 候选值 | 要记录的结果 |
|---|---|---|
| 高斯核大小 | 5x5 / 7x7 / 9x9 | 噪声误检与小目标漏检 |
| 面积下限 | 0.01% / 0.05% / 0.1% | 不同拍摄距离的召回 |
| 圆形度阈值 | 0.7 / 0.8 / 0.9 | 倾斜硬币漏检与圆形杂物误检 |
异常处理
硬币重叠/粘连:常规轮廓检测会把两个贴在一起的硬币当成一个。解决方案是分水岭算法:
def watershed_split(binary: np.ndarray):
    # 距离变换 + 固定阈值候选种子;不保证粘连物体能分出独立种子
    dist = cv2.distanceTransform(binary, cv2.DIST_L2, 5)
    _, sure_fg = cv2.threshold(dist, 0.5 * dist.max(), 255, 0)
    sure_fg = np.uint8(sure_fg)
    unknown = cv2.subtract(binary, sure_fg)
    _, markers = cv2.connectedComponents(sure_fg)
    markers = markers + 1
    markers[unknown == 255] = 0
    # 分水岭需要 3 通道输入
    img_color = cv2.cvtColor(binary, cv2.COLOR_GRAY2BGR)
    markers = cv2.watershed(img_color, markers)
    return markers
这段分水岭代码是起点,不包含局部峰值分离;如果两个目标共享一个种子,仍无法拆开。需要展示种子图和失败例再判断是否有效。
光照不均:可把 CLAHE 作为预处理候选,与不使用它的结果对比;它也可能放大纹理噪声:
clahe = cv2.createCLAHE(clipLimit=2.0, tileGridSize=(8, 8))
gray = clahe.apply(gray)背景复杂:桌面有纹理或杂物时,用 GrabCut 先做前景分割:
mask = np.zeros(img.shape[:2], np.uint8)
bgd_model = np.zeros((1, 65), np.float64)
fgd_model = np.zeros((1, 65), np.float64)
rect = (50, 50, img.shape[1] - 100, img.shape[0] - 100)
cv2.grabCut(img, mask, rect, bgd_model, fgd_model, 5, cv2.GC_INIT_WITH_RECT)
foreground = np.where((mask == 1) | (mask == 3), 255, 0).astype(np.uint8)
GrabCut 的耗时取决于分辨率、迭代次数与设备。上述矩形还要求图像宽高大于 100,且目标不触边;它不是通用的自动前景定位方案。
四、效果评估与优化
评估时保留一组没有参与调阈值的图片,并把成功与失败样本一起展示。只展示光照干净、目标居中的输入,很难说明方案能应对实际使用。还应记录背景复杂、目标粘连、倾斜和读取失败时程序会怎样返回。
测试集
建议先建立 50 张人工标注的试验集,再根据失败分布扩充;以下是采集配额,不是已拥有的数据:
- 正面光照(25 张)
- 侧光(10 张)
- 反光强烈(10 张)
- 复杂背景(5 张)
准确率
本仓库没有对应照片、逐图预测与计时日志,因此撤下旧版的“93.2%”和分场景成绩。若按 50 张图片逐图二值计分,正确率只能以 2 个百分点变化,93.2% 本身就与该口径不一致。正式报告应包含:
| 指标 | 口径 | 当前状态 |
|---|---|---|
| 计数完全正确率 | 预测数量等于标注数量的图片数 / 图片总数 | 待真实照片测试 |
| 计数 MAE | 每图绝对计数误差的平均值 | 待真实照片测试 |
| 逐枚分类准确率 | 正确分类枚数 / 已匹配标注枚数,另报检测召回与拒识率 | 待标定与标注 |
| 延迟 p50/p95 | 固定设备与分辨率,明确是否包含读写图 | 待计时日志 |
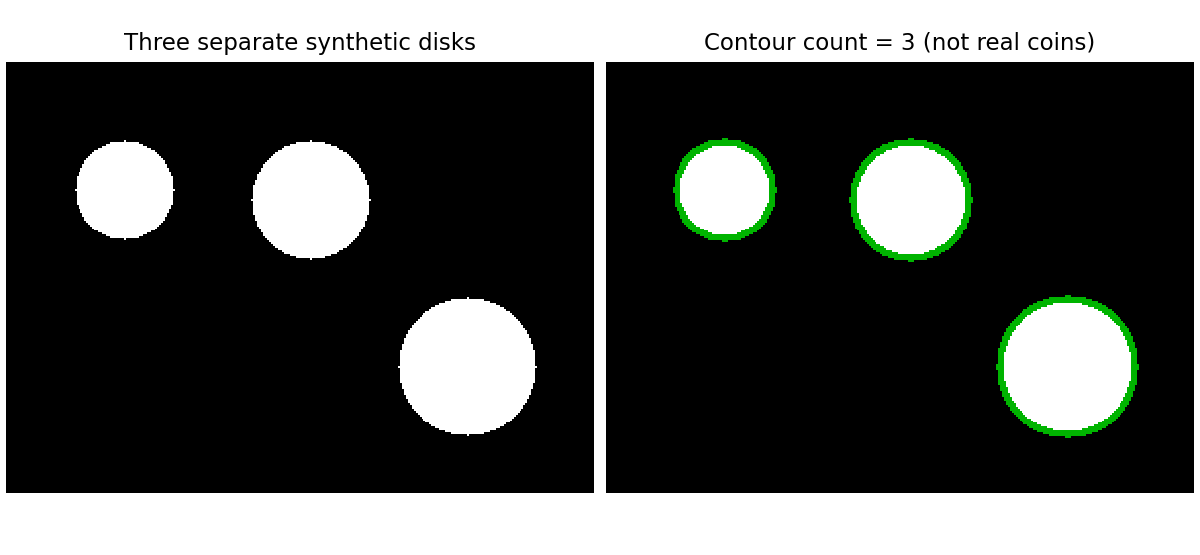
本轮实际执行的最小检查,是从合成二值图中筛出 3 个圆盘。它只覆盖轮廓与圆形度链路,不覆盖手机照片预处理、币种分类或金额计算,不能作为 90% 目标达成证据。复跑结果
需要采集的失败案例(不是已归档实测)
- 反光导致轮廓断裂:1 元硬币表面高光让二值化后边缘断开,被识别成 3 个小硬币。修复思路是用霍夫圆变换作为后备——当圆形度低于阈值但区域内有强圆形霍夫响应时,合并碎片。
- 极小硬币被过滤:远处拍的 1 角硬币半径只有 15 像素左右,被面积下限过滤掉。修复思路是动态调整面积阈值,根据图中最小硬币半径自适应。
性能优化
- 降分辨率处理:可对比原图与缩小图,再把坐标映射回原图;同比例缩放时也必须同步更新毫米/像素比例。记录小目标召回和耗时,不承诺固定倍数的加速。
- 多线程批处理:
from concurrent.futures import ThreadPoolExecutor

def batch_process(image_paths: list[str], max_workers: int = 4):
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        results = list(executor.map(process_single, image_paths))
    return results
上面依赖尚需实现的 process_single,只是批处理封装示意。线程池是否加速要测量,还要避免与 OpenCV 内部线程过度竞争;本轮没有批处理计时结果。
五、部署与封装
CLI 工具
用 click 包做命令行接口,比 argparse 更友好:
import click
import cv2

@click.command()
@click.option("--input", "-i", required=True, help="输入图片路径")
@click.option("--output", "-o", default="result.jpg", help="输出图片路径")
def main(input, output):
    img = cv2.imread(input)
    if img is None:
        raise click.ClickException(f"cannot read {input}")

    binary = preprocess(img)
    coins = find_coins(binary, img)

    for index, coin in enumerate(coins, start=1):
        cv2.circle(img, coin["center"], int(coin["radius"]), (0, 255, 0), 3)
        cv2.putText(img, f"candidate {index}",
                    coin["center"], cv2.FONT_HERSHEY_SIMPLEX,
                    0.8, (0, 0, 255), 2)

    if not cv2.imwrite(output, img):
        raise click.ClickException(f"cannot write {output}")
    click.echo(f"圆形候选数量:{len(coins)}(未经真实照片验收)")
    click.echo(f"结果已保存至 {output}")

if __name__ == "__main__":
    main()
使用示例:
python coin_counter.py --input photo.jpg --output result.jpg依赖管理
# requirements.txt
opencv-python==4.9.0.80
numpy==1.26.4
Pillow==10.2.0
click==8.1.7
上面是旧版依赖快照,不代表已在任意 Python 3.10+ 上验证。需要将前文的 preprocess、find_coins 和 CLI 放进同一文件,并在隔离环境中锁定兼容版本;Pillow 并非当前计数代码必需。此次合成例子的实际环境为 Python 3.13.7、OpenCV 4.12.0、NumPy 2.2.6,完整版本写在结果 JSON,未执行照片 CLI。
六、从教程到项目的经验总结
教程不会告诉你的工程细节
- 异常路径也是验收对象:读取失败、没有候选、未知类别和保存失败应有明确返回,不能悄悄算成正确结果。
- 参数标定是核心工程问题:scale 系数不标定,半径分类毫无意义;面积阈值要根据图像分辨率自适应
- 降分辨率有代价:小目标和细边缘可能消失;只有同一验证集的质量与耗时记录,才能决定是否采用。
把笔记转化为可复用代码的关键
教程笔记是”知道有这个 API”,项目代码是”知道在什么条件下用这个 API、参数怎么调、失败了怎么 fallback”。跨越这个鸿沟的关键是想清楚输入输出的边界:
- 输入:什么分辨率?什么光照?什么背景?最坏情况长什么样?
- 输出:精度要求多少?延迟要求多少?失败时返回什么?
把这两个问题写在代码注释里,每个函数都明确”我接受什么、我保证什么”,代码自然就从”能跑的脚本”变成了”可复用的模块”。
下一个项目想做什么
- 文档扫描矫正:用边缘检测 + 透视变换把手机拍的文档拉平,比硬币计数更实用
- 简单 OCR 工具链:硬币项目让我对 OpenCV 预处理理解更深,下一步可以接 Tesseract/paddleocr 做完整 OCR
教程笔记是积木,项目是把积木搭成房子的过程。希望这篇笔记能帮同样在”教程到项目”门槛前徘徊的朋友少走点弯路——挑一个具体场景,定义清楚输入输出,然后把笔记里的 API 一个个串起来跑通,你就跨过去了。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。