
文章多了之后,按发布时间阅读不一定合适:有些知识需要先学,有些可以等遇到项目问题再回查。这份路线按主题和前置关系整理已有课程。你可以从不熟悉的模块开始,已经能完成自测的部分直接跳过;周数只是安排节奏的参考,不是必须遵守的进度。
难度标注:⭐ 入门(零基础可读)|⭐⭐ 进阶(需要模块内前置)|⭐⭐⭐ 实战/深入(建议动手后再读)
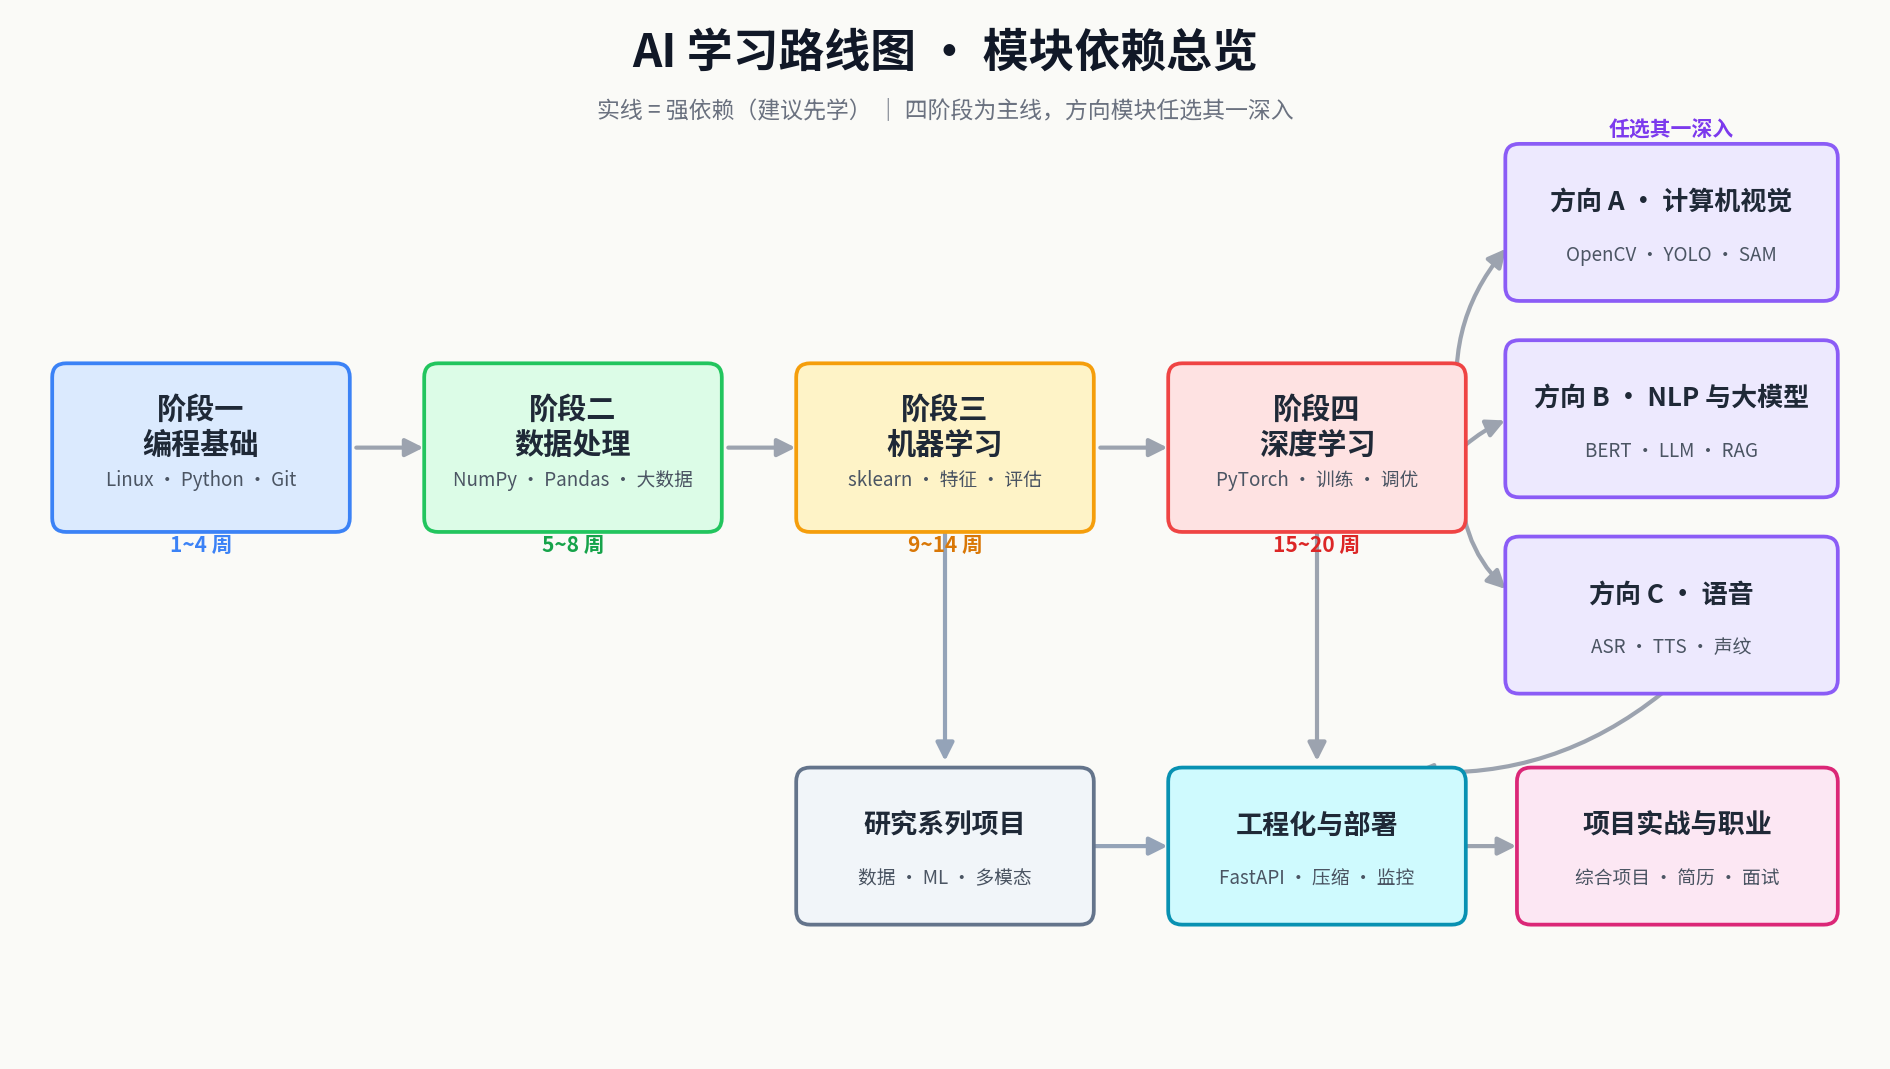
阶段一:编程与工具地基(第 1~4 周)
目标:能在 Linux 服务器上独立跑起 Python 项目,代码有工程素养。
Python 语言(按顺序读):
| 文章 | 难度 |
|---|---|
| Python 从入门到进阶指南 | ⭐ |
| 数据类型与容器 | ⭐ |
| 控制流语句 | ⭐ |
| 可变性与集合类型 | ⭐ |
| 列表字典推导与魔法方法 | ⭐⭐ |
| 迭代器与生成器 | ⭐⭐ |
| Python 高级编程 | ⭐⭐ |
| 正则表达式与文本处理 | ⭐⭐ |
| 包管理与虚拟环境 | ⭐ |
Linux 与工程环境:
| 文章 | 难度 |
|---|---|
| Linux 与 Python 环境基础 | ⭐ |
| 开发环境搭建 | ⭐ |
| Git 版本控制 | ⭐ |
| Jupyter 与可复现性 | ⭐⭐ |
| Python 项目工程化 | ⭐⭐ |
| Shell 与 Linux 训练运维 | ⭐⭐ |
自测:能在服务器上用 tmux 跑一个过夜任务、会用 Git 管理实验代码、能独立配置 conda 环境,过关。
阶段二:数据处理与分析(第 5~8 周)
目标:拿到任何结构化数据,能清洗、分析、可视化、讲故事。
| 文章 | 难度 |
|---|---|
| NumPy 笔记 | ⭐ |
| Pandas 数据分析与可视化 | ⭐ |
| NumPy 与 Python 性能优化 | ⭐⭐ |
| 数据可视化叙事 | ⭐⭐ |
| 数据采集与爬虫 | ⭐⭐ |
| SQL 数据库实践 | ⭐ |
| Dask 与 Polars:超越 Pandas | ⭐⭐⭐ |
| 大数据管理概论 | ⭐⭐ |
| Hadoop 与 Hive 数据仓库 | ⭐⭐ |
| PySpark 与 Airflow 流水线 | ⭐⭐⭐ |
| Kafka 流处理基础 | ⭐⭐ |
| NoSQL 选型 | ⭐⭐ |
自测:独立完成一次端到端分析——爬取或下载一个真实数据集,清洗后产出一份带图表的分析报告。
阶段三:机器学习核心(第 9~14 周)
目标:理解经典算法的原理与适用边界,能独立完成一个 Kaggle 级别项目。
基础与数学:
| 文章 | 难度 |
|---|---|
| 机器学习数学基础 | ⭐ |
| 信息论基础 | ⭐⭐ |
| 机器学习基础与 Scikit-learn | ⭐ |
算法专题(线性→树→集成→无监督,按此顺序):
| 文章 | 难度 |
|---|---|
| 线性回归 | ⭐ |
| 逻辑回归与 SVM | ⭐⭐ |
| 朴素贝叶斯 | ⭐ |
| 决策树 | ⭐ |
| 集成学习:随机森林与 XGBoost | ⭐⭐ |
| K-Means 聚类 | ⭐ |
| 降维:PCA 与 UMAP | ⭐⭐ |
| 时间序列分析 | ⭐⭐ |
| 推荐系统基础 | ⭐⭐ |
| 异常检测实战 | ⭐⭐ |
工程方法(算法之后必读,决定你能否做出「能用的模型」):
| 文章 | 难度 |
|---|---|
| 特征工程实战 | ⭐⭐ |
| 模型评估与类别不平衡 | ⭐⭐ |
| 过拟合与正则化 | ⭐⭐ |
| 超参数搜索与 AutoML | ⭐⭐ |
| 数据集构建与标注 | ⭐⭐ |
| 模型可解释性 SHAP | ⭐⭐ |
| 因果推断基础 | ⭐⭐⭐ |
| A/B 测试与统计 | ⭐⭐ |
| Kaggle 参赛指南 | ⭐⭐⭐ |
自测:Kaggle 上选一个入门赛(Titanic 之后的表格赛),独立进前 20%,过关。
阶段四:深度学习(第 15~20 周)
目标:理解训练的全部细节,能手写训练循环,能调通一个真模型。
核心系列(01~10 严格按序):
| 文章 | 难度 |
|---|---|
| 训练循环与自动求导 | ⭐ |
| 反向传播推导 | ⭐⭐ |
| 训练稳定性实战 | ⭐⭐ |
| CNN 图像分类 | ⭐⭐ |
| 迁移学习项目 | ⭐⭐ |
| RNN、LSTM 与 GRU | ⭐⭐ |
| Transformer 注意力详解 | ⭐⭐ |
| TensorFlow/Keras 工程化 | ⭐⭐ |
| PaddlePaddle 中文文本分类 | ⭐⭐ |
| 模型评估调参与部署 | ⭐⭐ |
训练进阶:
| 文章 | 难度 |
|---|---|
| 优化器与学习率调度 | ⭐⭐ |
| 混合精度与显存优化 | ⭐⭐⭐ |
| 分布式训练基础 | ⭐⭐⭐ |
| 强化学习基础 | ⭐⭐ |
| 强化学习进阶:DQN 到 PPO | ⭐⭐⭐ |
| 自监督学习 | ⭐⭐⭐ |
| 图神经网络 | ⭐⭐⭐ |
自测:不看教程从零写一个 CNN 训练脚本(含混合精度、学习率调度、验证评估),在 CIFAR-10 上跑到 90%+,过关。
模块五:计算机视觉
建议顺序:OpenCV 传统视觉 → 检测/分割 → 前沿专题 → 实战。
| 文章 | 难度 |
|---|---|
| OpenCV 图像基础操作 | ⭐ |
| 几何变换 | ⭐ |
| 轮廓与特征提取 | ⭐⭐ |
| 霍夫变换与亮度处理 | ⭐⭐ |
| OpenCV 实用技巧 | ⭐⭐ |
| OpenCV 实战项目 | ⭐⭐ |
| 人脸识别 | ⭐⭐ |
| 目标检测 YOLO | ⭐⭐ |
| 图像分割 U-Net | ⭐⭐ |
| OCR 文字识别 | ⭐⭐ |
| 数据增强:Mixup 与 CutMix | ⭐⭐ |
| SAM 与开放词汇检测 | ⭐⭐⭐ |
| 超分辨率 ESRGAN | ⭐⭐⭐ |
| 姿态估计与多目标跟踪 | ⭐⭐⭐ |
| ViT 与 CLIP 多模态 | ⭐⭐⭐ |
| 图像生成:GAN 与扩散模型 | ⭐⭐⭐ |
| 3D 视觉与点云 | ⭐⭐⭐ |
| 视频理解基础 | ⭐⭐⭐ |
| 工业视觉质检项目 | ⭐⭐⭐ |
模块六:NLP 与大模型
建议顺序:NLP 全景 → 表示演进 → LLM 专题 → RAG/Agent。
模块七:语音
| 文章 | 难度 |
|---|---|
| 语音识别基础 | ⭐ |
| 声学模型:CTC 与 RNN-T | ⭐⭐⭐ |
| Whisper 微调与声音克隆 | ⭐⭐ |
| 语音合成 TTS | ⭐⭐ |
| 声纹识别 | ⭐⭐ |
模块八:工程化与部署
模型训练的终点是上线。这一模块决定你是「炼丹师」还是「工程师」。
| 文章 | 难度 |
|---|---|
| FastAPI 模型服务 | ⭐⭐ |
| 模型压缩与部署 | ⭐⭐⭐ |
| 端侧与移动端部署 | ⭐⭐⭐ |
| 实验追踪与模型监控 | ⭐⭐ |
| vLLM 性能调优实录 | ⭐⭐⭐ |
| AI 自动化工作流 | ⭐⭐ |
| AI 编程助手实战 | ⭐ |
| ML 系统设计面试 | ⭐⭐⭐ |
模块九:项目实战与职业
| 文章 | 难度 |
|---|---|
| 综合实战一:Streamlit 应用 | ⭐⭐ |
| 综合实战二:项目复盘 | ⭐⭐ |
| 综合实战三:求职答辩 | ⭐⭐ |
| 智能客服端到端项目 | ⭐⭐⭐ |
| AI 简历与作品集 | ⭐ |
| 论文复现方法论 | ⭐⭐ |
| AI 研究方法 | ⭐⭐ |
模块十:研究系列(AI 科研内容平台)
一个贯穿十余篇的完整研究项目,覆盖数据(开放数据 API、Scrapy 与 Playwright、清洗、EDA、DuckDB)、数据管理(Postgres、FastAPI、Prefect、Docker CI/CD)、机器学习(特征、分类、回归、聚类、评估)与多模态理解(PDF 解析、语义检索、深度文本模型、图表公式、多模态融合、里程碑)。适合阶段四之后作为综合演练。
三条给不同人的路线建议
- 在校生/转行者:严格按阶段一到四走,模块五到七按兴趣选一个深入(推荐 CV 或 NLP),全程约 24 周。
- 在职工程师补 AI:跳过阶段一,从阶段三快速过一遍,重点投入阶段四 + 模块六(LLM),约 10 周。
- 目标是就业:四个阶段 + 模块八 + 模块九的简历面试篇,项目至少做出两个可演示的。
通用学习纪律
- 每篇文章的练习必须动手——只读不练的吸收率不足 20%。
- 踩坑表比正文值钱——那是别人花时间买的教训,遇到报错先查表。
- 卡壳两周以上就换路线——先往后走,很多前置知识会在后面被「用会」。
- 输出倒逼输入——学完一个模块,自己写一篇复盘或给身边人讲一遍。
路线图会随新文章持续更新。祝学习顺利。
相关阅读:AI 简历与作品集、Kaggle 参赛指南、论文复现方法论。

💬 评论
这套方案在哪一步卡住了?也欢迎补充你的实现方式或踩坑经验。